
ARIA SVS v3.0NEXTβ
- Digital500 JPY
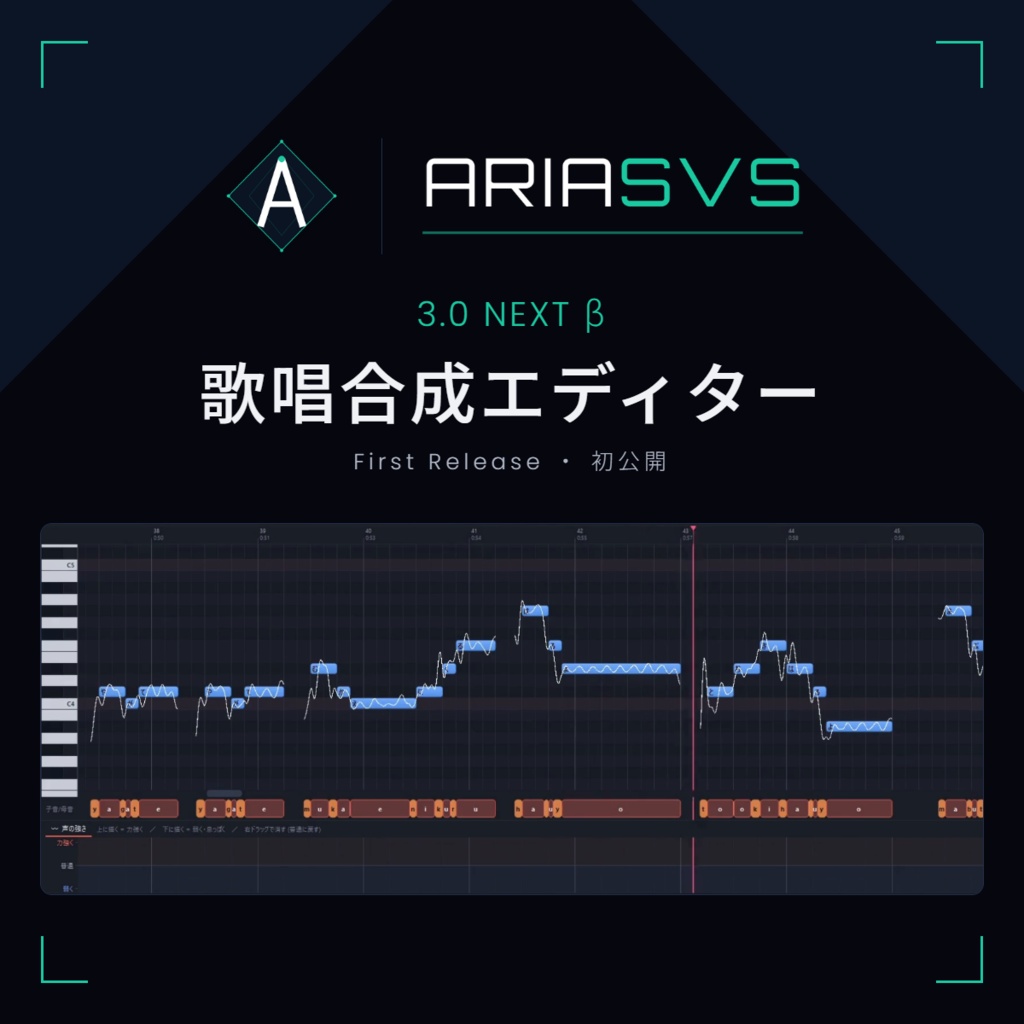
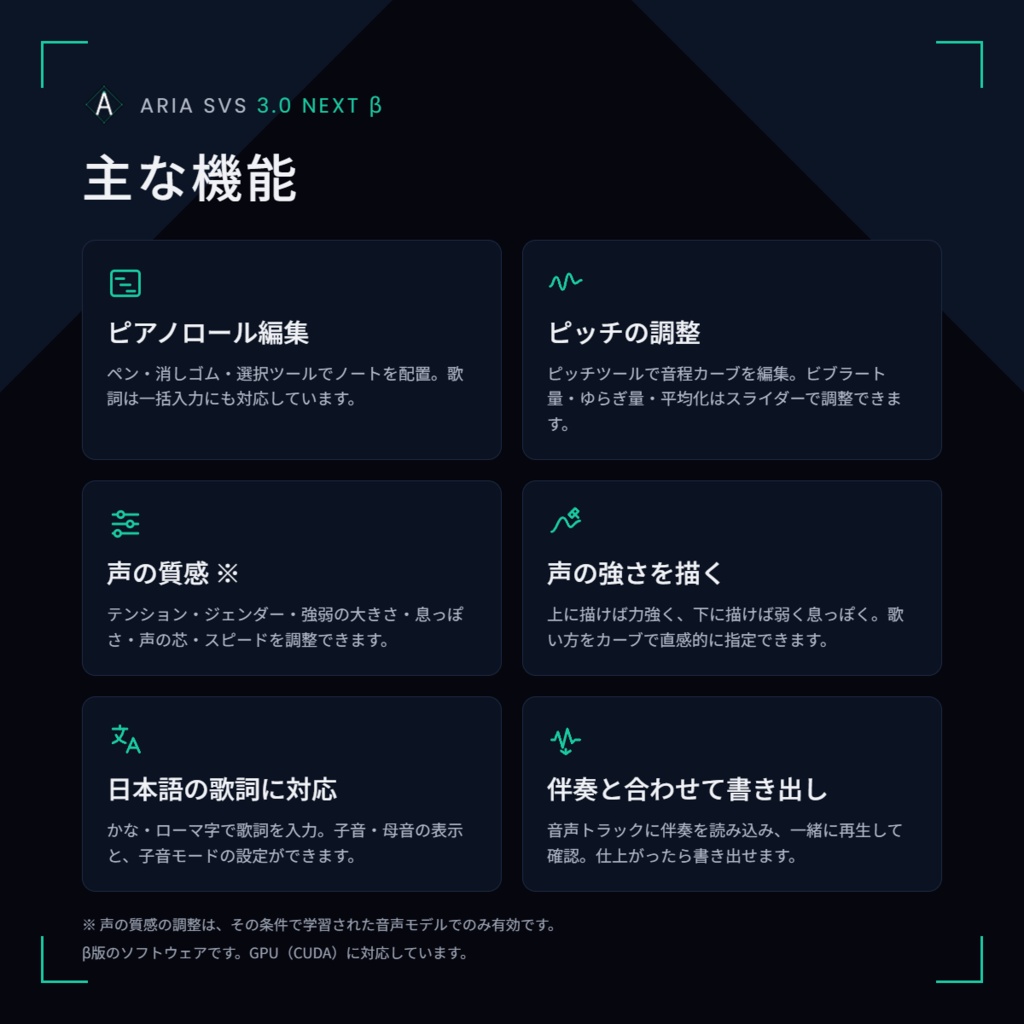
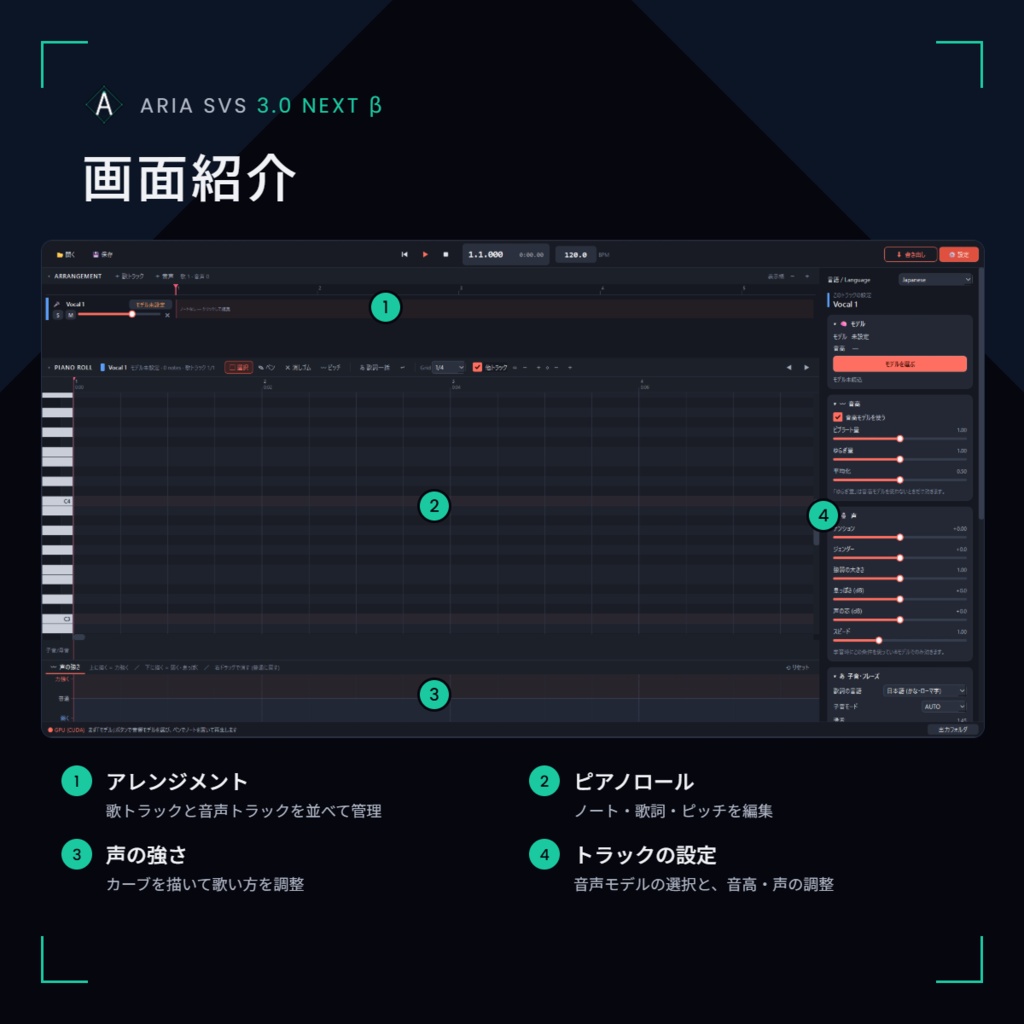


【ARIA SVS 3.0 NEXT】 歌唱合成ソフトウェア「ARIA SVS 3.0 NEXT」 【重要】 本ソフトウェア単体では歌わせることができません。 歌唱を行うには、別途ARIA SVS 3.0 NEXT対応のボイスモデルが必要です。 本ソフトウェアは、ARIA SVS 3.0 NEXT用のモデルに対応しています。 他のバージョン・形式のモデルには対応していません。 ボイスモデルは、ソフトウェアと一緒に最新版をご利用ください。 【ARIA SVSのモデルなど】 https://booth.pm/wish_list_names/p6kT3NG3 【開発・制作へのご協力】 本ソフトウェアの開発・制作には、以下の方々からご協力・ご支援をいただいています。 ・FuwaFuwaP ・雅王とらい ・みどり色のようじょ 本プロジェクトへのご協力・ご支援に心より感謝いたします。 【使い方】 使い方については、以下のマニュアルをご覧ください。 https://docs.google.com/presentation/d/1HwxqoWoL2tDdHQnP5CBQ7VOuI57BJZGQFHNmHLDc-GQ/edit?usp=sharing ──────────────────────── 【ボコーダーと学習データについて】 本ソフトウェアで使うボコーダー(音声の波形を作る部品)は、各ボイスモデルの中に入っています。 本ソフトウェア本体には、ボコーダーは入っていません。 ボコーダーの学習には、以下のデータを使用しています。 ■ 「波音リツ」歌声データベース 音源収録者: カノン Website: https://www.canon-voice.com/ 「波音リツ」歌声データベースの利用規約に従って使用しています。 波音リツの音声を、ボコーダーの学習データの一部に使用し、 そのボコーダーを、他のボイスモデルにも組み込んでいます(ベースモデル等としての利用)。 この使い方について、音源収録者のカノン様に確認し、許諾をいただいています。 クレジット: 「波音リツ」 / 「カノン」 ■ VocalSet: A Singing Voice Dataset Authors: Julia Wilkins, Prem Seetharaman, Alison Wahl, Bryan Pardo License: Creative Commons Attribution 4.0 International (CC BY 4.0) DOI: https://doi.org/10.5281/zenodo.1203819 VocalSetは、プロの歌手による歌唱音声を収録したデータセットです。 ■ CSTR VCTK Corpus Provider: Centre for Speech Technology Research (CSTR), University of Edinburgh License: Creative Commons Attribution 4.0 International Public License (CC BY 4.0) DOI: https://doi.org/10.7488/ds/2645 VCTK Corpusは英語のマルチスピーカー音声コーパスです。 ■ SingVERSE Provider/Project: Amphion License: Creative Commons Attribution 4.0 International (CC BY 4.0) Dataset: https://huggingface.co/datasets/amphion/SingVERSE Paper: https://arxiv.org/abs/2509.20969 SingVERSEは、歌唱音声を扱う音声データセットです。 ■ LibriSpeech ASR Corpus Authors: Vassil Panayotov, Guoguo Chen, Daniel Povey, Sanjeev Khudanpur Provider: OpenSLR (SLR12) License: Creative Commons Attribution 4.0 International (CC BY 4.0) Dataset: https://www.openslr.org/12 Paper: V. Panayotov, G. Chen, D. Povey and S. Khudanpur, "Librispeech: An ASR corpus based on public domain audio books", ICASSP 2015. DOI: https://doi.org/10.1109/ICASSP.2015.7178964 LibriSpeechは、LibriVoxのパブリックドメインの朗読音声から作られた 英語の音声コーパスです。 使用にあたり、音声を44.1kHzのモノラル・16bitに変換し、一部のみを選んで使用しています。 学習のために、上記のすべてのデータの音声を44.1kHzに変換しています。 ■ ボコーダーの元になったソフトウェア NHVSing Copyright (c) 2025 wavtechyukky License: MIT https://github.com/wavtechyukky/NHVSing NHVSingは、次の論文に基づいています。 Z. Liu, Y. Wang, K. Chen and Y. Jia, "Neural Homomorphic Vocoder," Interspeech 2020, pp. 3500-3504. ──────────────────────── 【データセットの再配布について】 本商品に含まれるソフトウェアおよびモデルは、 上記データセットに含まれる元の音声ファイルそのものを再配布するものではありません。 本商品には、各データセットの音声ファイルをそのまま収録・同梱していません。 各データセットの著作権・ライセンス・利用条件は、 それぞれの権利者および公式配布元に帰属します。 【ライセンスについて】 本ソフトウェアの学習に使用したデータには、 それぞれ異なるライセンス条件があります。 本ソフトウェアでは、各データのライセンス条件を確認した上で利用しています。 特に、CC BY 4.0で提供されているデータセットについては、 ライセンスで定められた著作者表示・ライセンス表示その他の条件に従って使用しています。 データ自体の利用条件については、 必ず各公式配布元のライセンスをご確認ください。 本ソフトウェアが使用するその他のライブラリのライセンスは、 インストール先の「THIRD_PARTY_LICENSES.txt」に記載しています。 【利用規約】 本商品を購入・利用した時点で、以下の利用規約に同意したものとします。 利用規約: https://sites.google.com/view/ariasvs/