
不可視文字とUnicode正規化の位置マップ
- Digital980 JPY
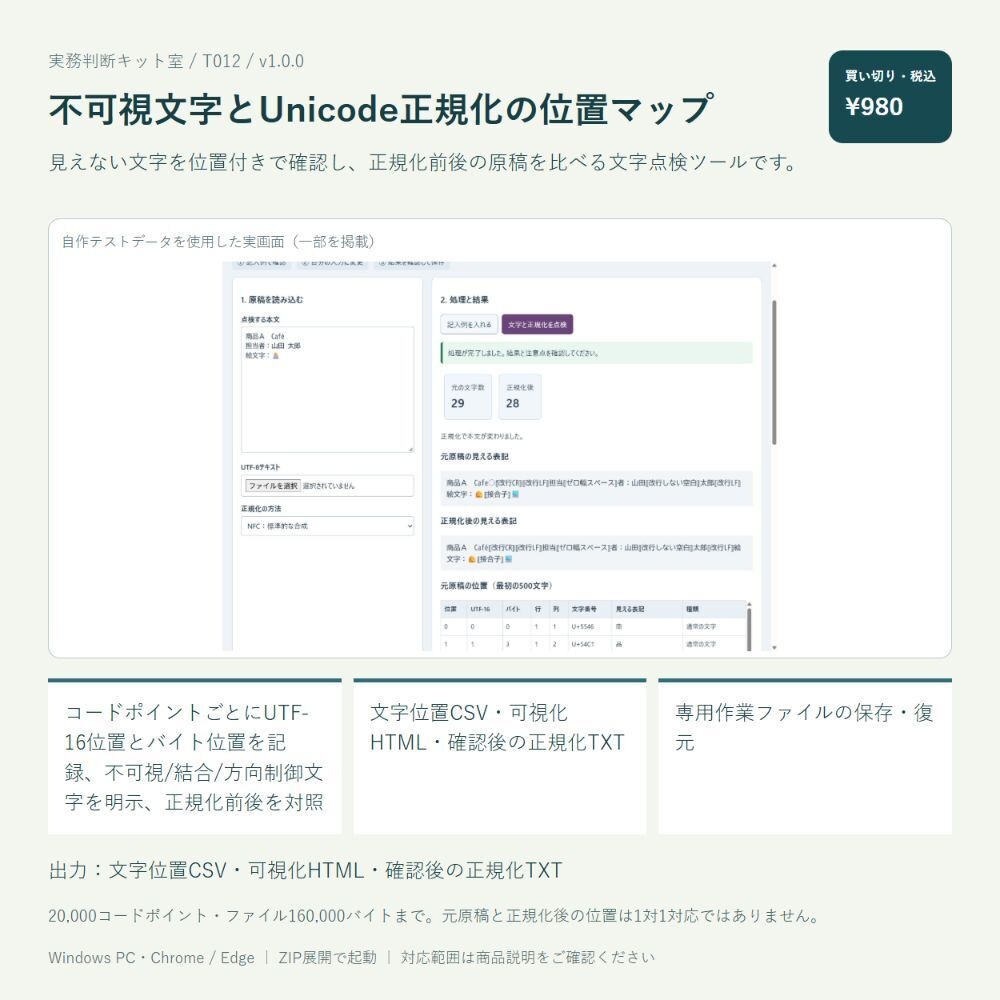
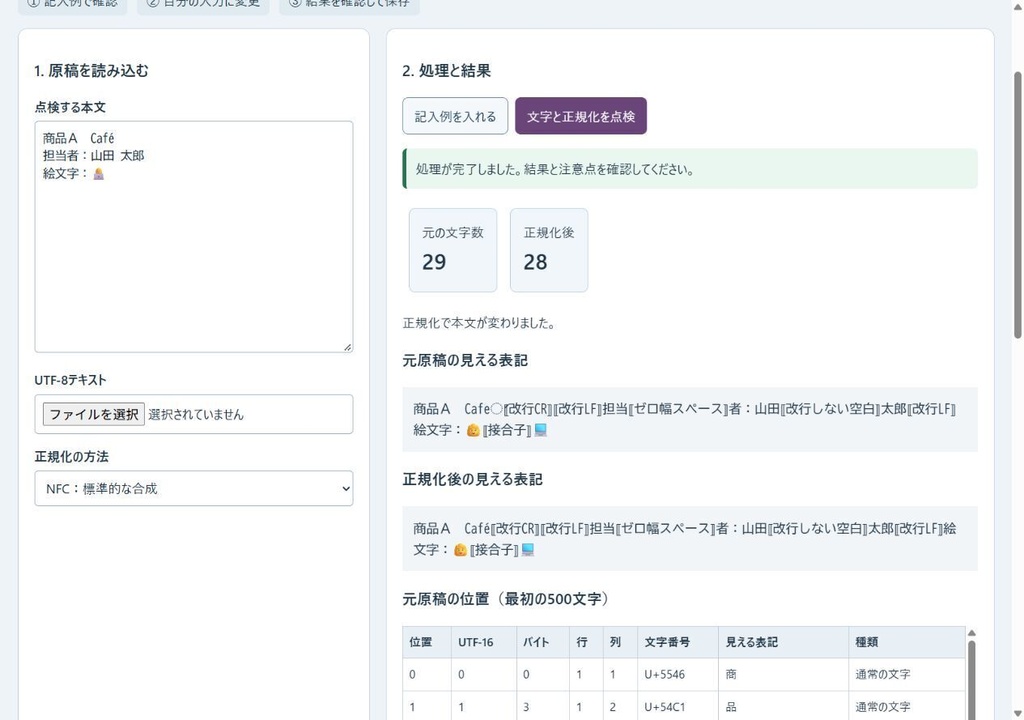


不可視文字とUnicode正規化の位置マップ 見えない文字を位置付きで確認し、正規化前後の原稿を比べる文字点検ツールです。 対象:原稿受領・翻訳・データ整備担当 できること:コードポイントごとにUTF-16位置とバイト位置を記録、不可視/結合/方向制御文字を明示、正規化前後を対照 出力:文字位置CSV・可視化HTML・確認後の正規化TXT 対応範囲・できないこと: 2万コードポイントまで。位置は元原稿のコードポイント・UTF-16・UTF-8バイトが0始まり、行・列が1始まりです。正規化後との1対1対応ではありません。ファイルのBOM・CRLFは保持しますが本文欄を編集すると改行はLFになります。似た字すべての判別は行いません。 WindowsのChrome/EdgeでZIPを全展開しapp.htmlを開くローカルHTMLツールです。サーバー・外部API不要。入力を外部送信しません。専用作業ファイルの明示保存・復元に対応し、自動保存はありません。読込はUTF-8のみです。 同梱:app.html、core.js、ui.js、common.js、style.css、README.txt、sales.txt。 表示例は架空の記入例です。効果・売上・完全性の保証はありません。操作と対応範囲をご確認ください。 利用範囲:個人端末・自社内業務。商品ファイルの再販売・再配布不可。生成出力はご自身の資料に利用可能。 【ファイル容量と原稿の上限】 テキストファイルは160,000バイト、原稿は20,000コードポイント(文字番号単位)まで。絵文字の組合せは複数として数えます。 作業ファイルはUTF-8で32,000,000バイト(32MB)まで。保存前と復元時に同じ上限を確認します。上限超過は日本語で停止し、入力を保持します。文字数上限では絵文字などを2文字分として数える場合があります。