配信で呼びかけるとキャラが声で返事する演出キット|Live2D+音声認識セットアップ手順書+設定ファイル例
- ダウンロード商品¥ 1,500
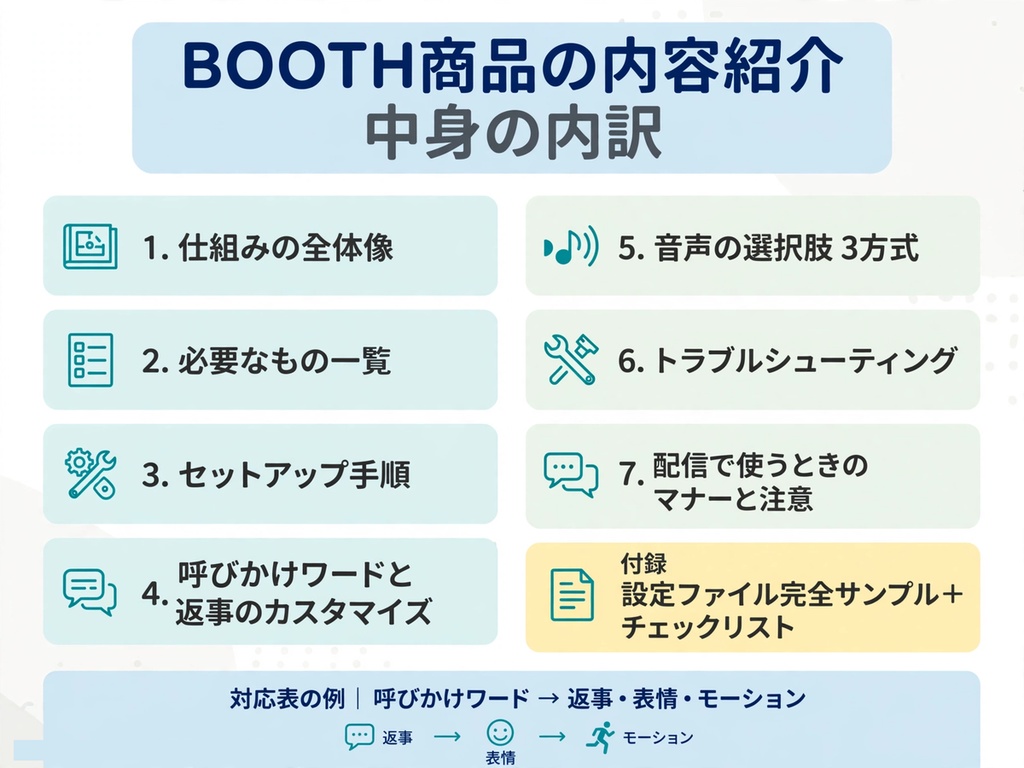
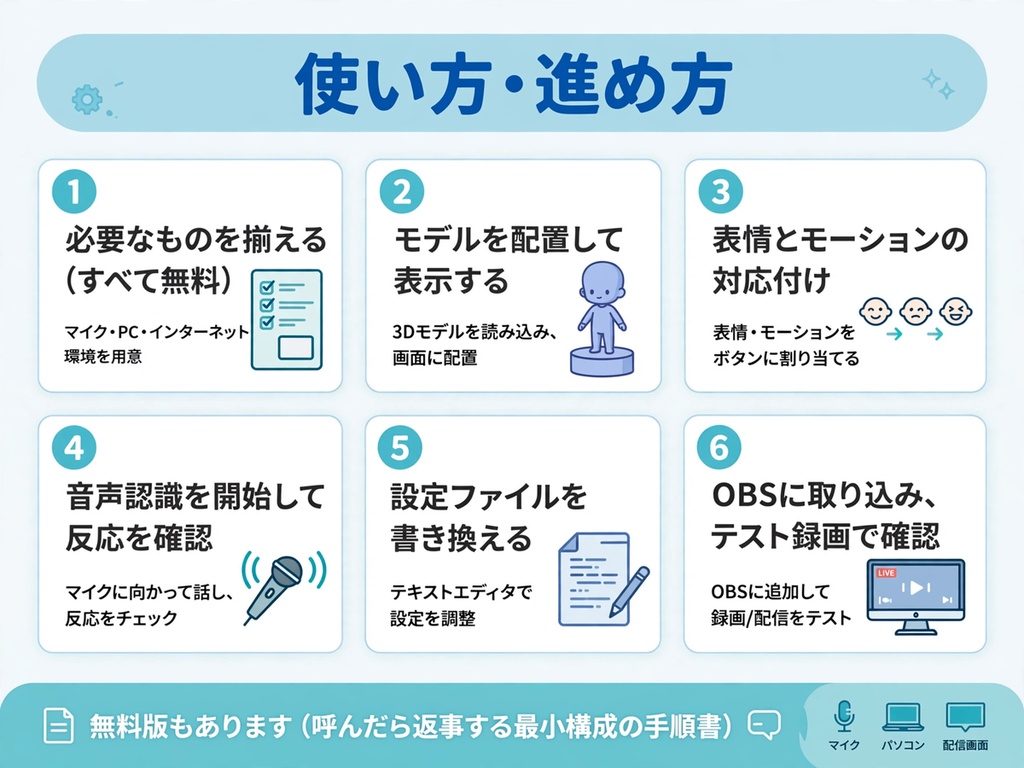


配信画面の中のキャラクターに名前を呼んでもらえたら――ではなく、 「あなたが呼んだら、キャラクターが返事をする」演出を、 自分の配信に入れるためのキットです。 マイクに向かってキャラクターの名前を呼ぶと、画面の中の キャラクターが笑顔になって手を振り、「は〜い」と声で返事をする。 本商品は、その仕組みを無料で揃う道具だけで組み立てるための セットアップ手順書と、設定ファイル例のダウンロードキットです。 この仕組みは、制作側が実際に作って動作を確認したものです。 Live2D公式サンプルモデルをブラウザで表示するビューアを自作し、 ブラウザの音声認識(Web Speech API)で呼びかけを聞き取り、 笑顔の表情+手を振るモーション+読み上げ音声で「は〜い」と 返事をする動作まで実装しました。本書は、その手順を、 ご自身のモデルと環境で再現できる形に整理したものです。 ■ 仕組み(3つのステップ) 1. 聞く:ブラウザ(Chrome/Edge)がマイクの声を文章に変換する 2. 見つける:文章の中に、登録した呼びかけワードがあるか照合する 3. 返事する:表情・モーション・音声を同時に動かして返事をする 取り込みはOBS Studio(無料)で行います。詳しい図解は 本書の第1章と、この説明文の無料サンプルに掲載しています。 ■ こんな方に ・ゲーム配信・雑談配信で、画面の中のキャラクターと 掛け合いをする演出を入れてみたい方 ・Live2Dモデルを持っている/これから用意する方で、 モデルの表情やモーションをもっと活かしたい方 ・プログラミングの専門知識はないが、手順に沿って 設定ファイルの書き換えくらいならやってみたい方 ■ 内容物(有料版) 1. 仕組みの全体像(マイク→音声認識→キーワード判定→ モーション+音声再生の流れを文章で図解) 2. 必要なもの一覧(ブラウザ、OBS Studio、PCなど、 すべて無料で揃うものだけ。モデルの入手先の案内を含む) 3. セットアップ手順(ビューア画面の用意、モデルの配置、 表情・モーションの対応付け、音声認識の開始、 OBSへの取り込み、音声の取り込み、通しテストまで) 4. カスタマイズ方法(呼びかけワードの追加、認識の揺れ対策、 返事パターンの増やし方、クールダウン設定の考え方) 5. 音声の選択肢3方式(ブラウザ読み上げ/VOICEVOX等で 事前に作った音声ファイルの再生/自作TTS連携の考え方)と、 それぞれの利点・注意点・比較表 6. トラブルシューティング(返事が繰り返される自己ループ、 認識が途切れる、マイク許可、対応ブラウザの注意など) 7. 配信で使うときのマナー・注意(モデルのライセンス確認、 キャラクターの利用規約、音声素材の権利確認) 8. 設定ファイルの完全サンプル(呼びかけワードと返事の 対応表、判定と自己ループ防止の実装要点、CSV形式の 管理サンプル)と、動作テスト/配信前チェックリスト ■ 無料版と有料版の違い 無料版(別商品として配布予定)は、呼びかけ1グループ・ 返事の読み上げのみで「呼んだら返事する」が実際に動く 最小構成の手順書です。単体で使える内容になっています。 有料版では、次が増えます。 ・呼びかけワードを複数グループ登録する方法と、 認識の揺れ(表記ゆれ)を吸収する登録のコツ ・返事パターンのランダム選択と、直前と同じ返事を 避ける仕組み ・クールダウンの設計と、自己ループを防ぐ仕組みの詳細 ・音声ファイル再生(キャラクターの声で返事する方式)と 自作TTS連携の考え方 ・配信本番向けのトラブルシューティングと チェックリスト一式 ■ 使い方の流れ 1. 必要なものを揃える(第2章の一覧。すべて無料のものです) 2. モデルを配置し、ビューア画面に表示する 3. 表情とモーションの対応付けをする 4. 音声認識を開始し、呼びかけに反応することを確認する 5. 設定ファイルを書き換えて、自分の呼びかけと返事にする 6. OBSに取り込み、テスト録画で音のバランスを確認する ■ 無料サンプル 「仕組みの全体像」と「セットアップ手順の一部」を、 この説明文の後半にそのまま掲載しています。 購入前に、内容の進み方をご確認いただけます。 ■ ご購入前の注意(必ずお読みください) ・本商品は手順書と設定ファイル例です。完成済みの ビューアプログラム、Live2Dモデル、音声素材は 含まれません。モデルはご自身で利用できるものを ご用意ください(入手先の案内は本文にあります)。 ・モデルのライセンスや利用条件の確認は、購入者ご自身で 行ってください。本書に確認項目のチェックリストが ありますが、個別のモデルの利用可否を保証するものでは ありません。公式サンプルモデルにも利用条件があります。 ・対応環境は、Windows/macOSのPC、Google Chromeまたは Microsoft Edge、OBS Studioを想定しています。 音声認識はブラウザの機能を使うため、インターネット 接続が必要です。FirefoxやSafariでは音声認識が 使えない/制限される場合があります。 ・お使いの環境によっては、手順どおりでも音声認識や マイクが動作しない場合があります。本文に切り分けの 手順(トラブルシューティング)がありますが、すべての 環境での動作を保証するものではありません。 ・音声認識はブラウザ提供側の仕組みに依存します。 提供元の仕様変更により、将来動作が変わる可能性があります。 ・本キットは、視聴者数や収益の増加など、配信の成果を 保証するものではありません。「呼びかけに反応する 演出を、自分で用意できるようになる」ための内容です。 ・音声合成ソフトや表示の仕組みなど、本書で案内する 外部のソフト・素材の利用料は含まれません (案内するものはいずれも無料で使えるものです)。 ・本商品はデジタルデータです。返品・返金はBOOTHの 規約に従います。 ■ サポートについて ・本商品の誤りの修正アップデートと、内容に関する FAQ範囲のご質問には対応します。 ・個別の環境への導入代行、プログラムの個別開発、 配信運営の相談は含まれません。 ■ 利用条件(要旨) ・購入者ご本人と、ご本人の配信活動の範囲で ご利用いただけます。 ・本文・設定ファイル例自体の再配布、転載、再販売、 第三者への譲渡はできません。本キットを使って設定した ご自身の配信演出や、その配信自体の利用は自由です。 ・モデル・音声・ソフトの利用条件は、それぞれの 提供元の条件が優先します。 ■ 無料サンプル1:仕組みの全体像 [配信者の声] ↓ マイク [ブラウザ:音声認識(Web Speech API)] ↓ 認識した文章(テキスト) [キーワード判定] ↓ 登録した呼びかけワードと一致したら [返事の選択]ランダムに1つ選ぶ ↓ 同時に3つを動かす [表情を切り替える]+[モーションを再生する]+[音声を再生する/読み上げる] ↓ [ビューア画面]→ OBS Studioで取り込んで配信画面へ ポイントは2つあります。 ・返事の再生中は判定を止め、再生後もしばらく(クールダウン) 再判定しないこと。これがないと、キャラクター自身の 返事の声をマイクが拾って、返事が繰り返される 「自己ループ」が起きます。 ・音声認識はChrome/Edgeの機能を使います。ファイルを 直接開くのではなく、ローカルサーバー経由でビューア画面を 開くのが、マイク許可を得るための前提になります。 ■ 無料サンプル2:セットアップ手順の一部 ステップ1. モデルの配置と表示確認 1. 利用できるLive2Dモデル一式を model/ フォルダに置き、 設定ファイル(model3.json)が入っていることを確認する 2. ビューア画面をローカルサーバー経由で開く (例:python -m http.server 8000 のあと、 Chromeで http://localhost:8000/ を開く) 3. モデルが表示され、呼吸やまばたきなどの待機動作が 出ていることを確認する ステップ3. 音声認識の開始手順(骨子) 1. ビューア画面の「聞き取り開始」ボタンを押す 2. ブラウザがマイクの使用許可を求めたら「許可」を選ぶ 3. 呼びかけではない普通の言葉を話し、認識結果が画面に 文字として出ることを確認する (ここで文字が出なければ、マイク選択やOS側の設定の問題)