
Image to VRMA (Update v1.5.1)
- ダウンロード商品¥ 0
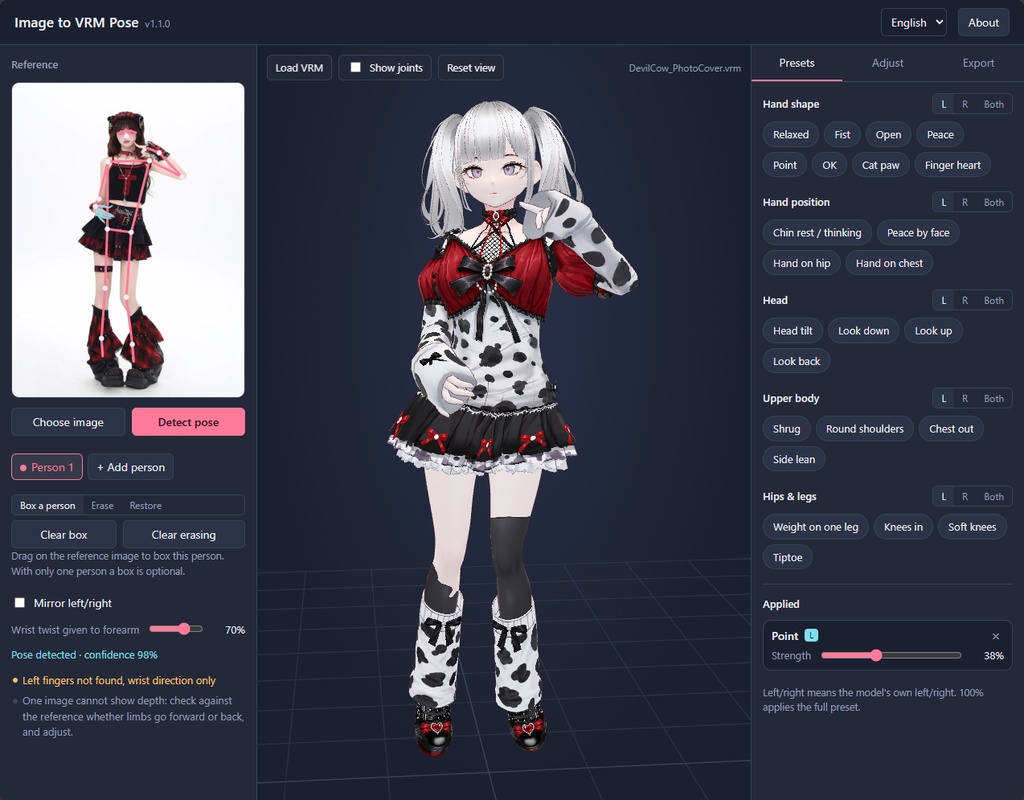
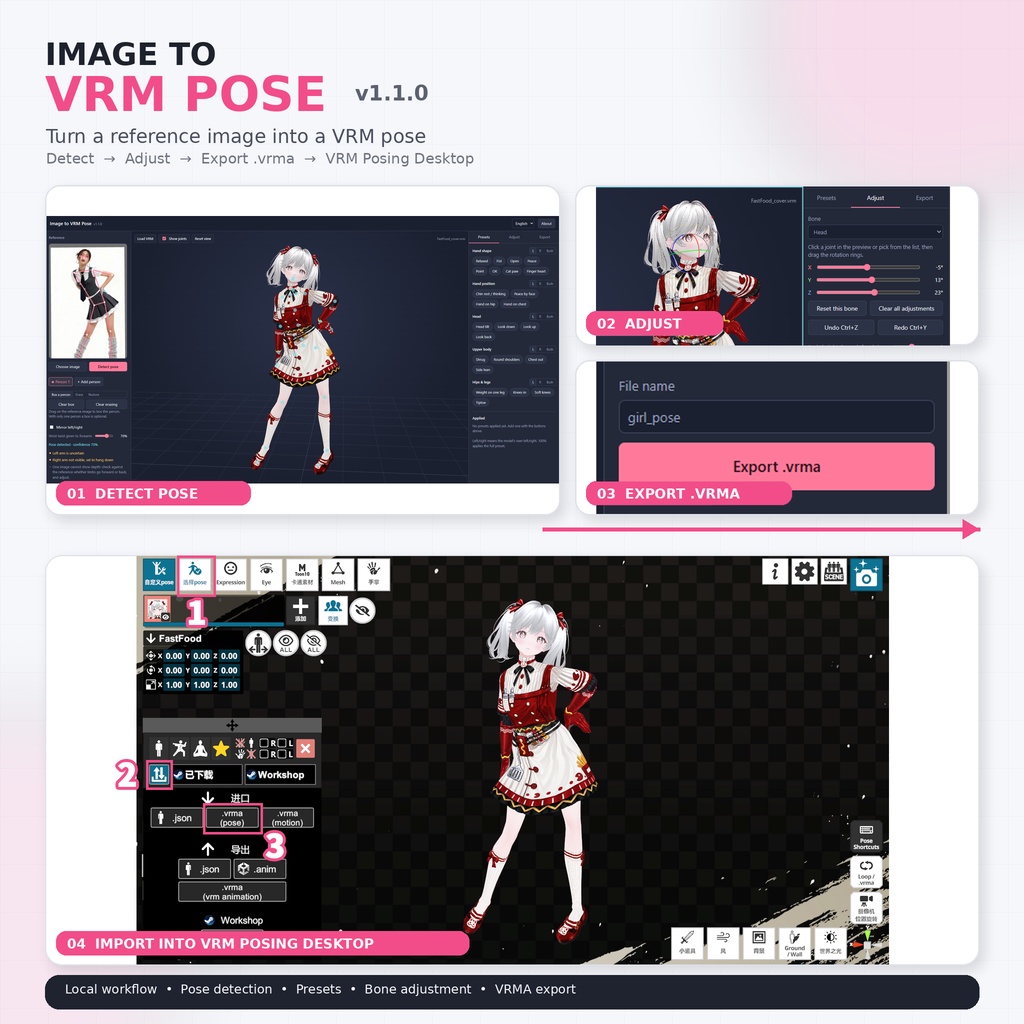


画像から VRM ポーズ v1.0.0 ========================== できること 参考画像の人物のポーズを検出して VRM に適用し、プリセットと微調整で整えて .vrma として書き出します。VRM Posing Desktop で読み込むと同じポーズになります。 使い方 1. フォルダごと解凍してください(html だけを取り出さないでください。lib フォルダが必要です)。 2. Chrome または Edge で「Image to VRM Pose.html」をダブルクリック。完全オフラインで動作します。 3. VRM を読み込む → 画像を選ぶ → ポーズを検出。初回は約 70MB のモデル読み込みで数秒かかります。 4. 「プリセット」で部分的なポーズ(手の形・手の位置・首かしげ・片足重心など)を追加。強さと左右を選べます。 5. 「微調整」でボーンを選び、スライダーまたは画面上の回転ギズモで調整。Ctrl+Z で元に戻せます。 6. 「書き出し」→ .vrma を書き出し。 既知の制限(必ずお読みください) - 1 枚の画像には本当の奥行きがありません。手足が前か後ろかを取り違えることがあるため、参考画像と見比べて微調整してください。 - 検出モデルは実写写真で学習されています。実写や 3D レンダー画像は比較的正確ですが、 イラスト(デフォルメ体型・大きな頭)では精度が大きく下がります。 - 指の検出は不安定です(手袋、小さい手、隠れた手など)。検出できない場合は手首の向きのみ使います。「手の形」プリセットで補ってください。 - 隠れている・画面外の手足は既定の姿勢(腕を下ろす・脚をまっすぐ)になります。 - 表情と視線は検出しません。 - 撮影アングル(俯瞰・あおり)は体の傾きとして扱われます。 プライバシー 画像とモデルはお使いの PC 内だけで処理され、アップロードされません。 利用規約 「利用規約_日本語.txt」をお読みください。 サードパーティライセンス MediaPipe(Apache License 2.0)、three.js(MIT)、@pixiv/three-vrm(MIT)。全文は LICENSES フォルダにあります。
EN
Image to VRM Pose v1.0.0 ======================== What it does Detects the body pose in a reference picture, applies it to your VRM, lets you refine it with presets and manual adjustment, and exports a .vrma you can import into VRM Posing Desktop. How to use 1. Unzip the whole folder (keep the lib folder next to the html file). 2. Open "Image to VRM Pose.html" in Chrome or Edge. Runs fully offline. 3. Load VRM -> Choose image -> Detect pose. The first run loads about 70 MB of models. 4. Presets: add partial poses (hand shapes, hand placements, head tilt, weight shift...), with strength and side. 5. Adjust: pick a bone and use the sliders or the rotation gizmo in the view. Ctrl+Z undoes. 6. Export -> Export .vrma. Known limitations (please read) - A single picture has no real depth: whether a limb points toward or away from the camera can be wrong. Compare with the reference and adjust. - The detector was trained on real photos. Photos and 3D renders work best; stylised illustrations (big heads, exaggerated proportions) are noticeably less accurate. - Finger detection is unreliable (gloves, small or hidden hands). When fingers are not found only the wrist direction is used; use the hand-shape presets instead. - Hidden or out-of-frame limbs are set to a default (arms down, legs straight). - Facial expression and gaze are not detected. - Camera angle (shot from above/below) is treated as body lean. Privacy Pictures and models are processed only on your computer and never uploaded. Terms of use Please read "Terms_of_Use_English.txt". Third-party licenses MediaPipe (Apache License 2.0), three.js (MIT), @pixiv/three-vrm (MIT). Full texts in the LICENSES folder.
CN
图片转 VRM 姿势 v1.0.0 ======================== 用途 识别参考图里的人物姿势,套到你的 VRM 上,再用预设和微调修整, 导出 .vrma,在 VRM Posing Desktop 里导入即可得到同样的动作。 使用方法 1. 解压整个文件夹(不要只拿出 html 文件,lib 文件夹必须在旁边)。 2. 用 Chrome 或 Edge 双击打开「Image to VRM Pose.html」。完全离线,不联网。 3. 载入 VRM → 选择参考图 → 识别姿势。第一次识别要载入约 70MB 模型,会等几秒。 4. 「预设」加局部动作(手势、手的位置、歪头、重心等),可调强度、选左右。 5. 「微调」选骨骼,用滑块或直接拖动画面里的旋转圈调整。Ctrl+Z 撤销。 6. 「导出」→ 导出 .vrma。 已知限制(请务必看) - 单张图没有真正的深度:手脚是往前还是往后伸,可能判断反,需要对照参考图微调。 - 识别模型是用真人照片训练的。真人照片、3D 渲染图效果较好; 二次元插画(夸张比例、大头)准确度明显下降。 - 手指识别不稳定,尤其是手套、小手、被遮挡的手;识别不到时只用手腕方向,请用「手势」预设补。 - 被遮挡或画面外的手脚会放成默认姿势(手自然下垂、腿站直)。 - 不识别表情和视线。 - 拍摄角度(俯拍、仰拍)会被算进身体倾斜里。 隐私 图片和模型只在你的电脑里处理,不会上传。 利用规约 请阅读「利用规约_中文.txt」。 第三方授权 MediaPipe(Apache License 2.0)、three.js(MIT)、@pixiv/three-vrm(MIT),全文见 LICENSES 文件夹。
KO
이미지로 VRM 포즈 v1.0.0 ======================== 할 수 있는 것 참고 이미지 속 인물의 포즈를 인식해 VRM에 적용하고, 프리셋과 미세 조정으로 다듬은 뒤 .vrma로 내보냅니다. VRM Posing Desktop에서 불러오면 같은 포즈가 됩니다. 사용 방법 1. 폴더 전체를 압축 해제하세요 (html 파일만 꺼내지 마세요. lib 폴더가 옆에 있어야 합니다). 2. Chrome 또는 Edge로 「Image to VRM Pose.html」을 더블클릭하세요. 완전히 오프라인으로 작동합니다. 3. VRM 불러오기 → 이미지 선택 → 포즈 인식. 처음에는 약 70MB의 모델을 불러오느라 몇 초 걸립니다. 4. 「프리셋」에서 부분 포즈(손 모양, 손 위치, 고개 갸웃, 한쪽 다리에 체중 등)를 추가합니다. 강도와 좌우를 고를 수 있습니다. 5. 「미세 조정」에서 본을 고르고 슬라이더나 화면의 회전 링으로 조정합니다. Ctrl+Z로 실행 취소. 6. 「내보내기」 → .vrma 내보내기. 알려진 한계 (꼭 읽어 주세요) - 이미지 한 장에는 실제 깊이 정보가 없습니다. 팔다리가 앞쪽인지 뒤쪽인지 반대로 판단할 수 있으니 참고 이미지와 비교해 조정해 주세요. - 인식 모델은 실사 사진으로 학습되었습니다. 실사 사진과 3D 렌더 이미지는 비교적 정확하지만, 일러스트(데포르메 체형, 큰 머리)는 정확도가 크게 떨어집니다. - 손가락 인식은 불안정합니다(장갑, 작은 손, 가려진 손 등). 인식하지 못하면 손목 방향만 사용하니 「손 모양」 프리셋으로 보완해 주세요. - 가려졌거나 화면 밖에 있는 팔다리는 기본 자세(팔은 내리고 다리는 곧게)가 됩니다. - 표정과 시선은 인식하지 않습니다. - 촬영 각도(위에서·아래에서 찍은 사진)는 몸의 기울기로 처리됩니다. 개인정보 이미지와 모델은 사용자의 PC 안에서만 처리되며 업로드되지 않습니다. 이용 약관 「이용약관_한국어.txt」를 확인해 주세요. 서드파티 라이선스 MediaPipe(Apache License 2.0), three.js(MIT), @pixiv/three-vrm(MIT). 전문은 LICENSES 폴더에 있습니다.
Update
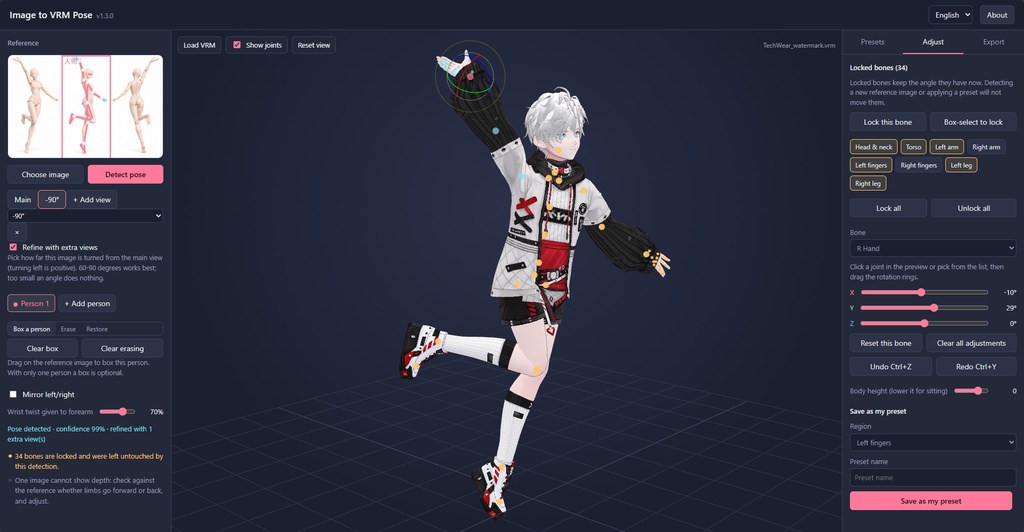
日本語 2026/09/26 (v1.5.1) v1.5.1 - 「参考画像を拡大」を追加(横長の画像や細かい枠指定に) - 修正:追加視点の角度を選ぶと参考画像が縮んでしまう問題 v1.5.0 - 関節角度の制限(既定でオン):ひじとひざをヒンジ扱い、前腕の回内を制限、 頭・首・手首を人体の範囲に - 顔の特徴が読めない場合(マネキン・後ろ姿・小さい顔)は頭を上半身に合わせる - 追加視点の角度の早見図(「?」ボタン) - 追加視点の角度の符号が逆と思われる場合に警告 - 制限の強さスライダーとオフ切り替え(誇張したポーズ用) v1.4.0 - マネキン(女性・男性)を内蔵し、VRM を読み込む前から使用可能に - ご自身の VRM を読み込むとマネキンと置き換わります - 2 人目には自動でもう一方のマネキンを割り当て v1.3.0 - ボーンのロック:ロックしたボーンは参考画像を差し替えて再検出しても そのまま。複数の参考画像を組み合わせられます - 部位ごと/3D プレビューでの範囲選択(Alt ドラッグで解除)/1 本ずつ - ロック中の関節はオレンジ色で表示 v1.2.0 - 多視点での精度向上:同じポーズの別角度の画像を追加して奥行きを算出 - 追加視点ごとに角度を指定。上下左右はメイン視点が決定 - ボーン長の制限により、検出の悪い追加視点でも結果が崩れにくい EN 2026/09/26 (v1.5.1) v1.5.1 - "Bigger reference" toggle for wide images and precise boxing - Fixed: reference image shrank when an extra view angle was selected v1.5.0 - Joint angle limits (on by default): elbows and knees as hinges, forearm pronation capped, head / neck / wrist kept in human range - Head follows the upper body when facial features can't be read (mannequins, back views, small faces) - Angle chart ("?") showing what each extra-view angle means - Warning when an extra view's angle sign looks reversed - Limit strength slider, and an off switch for exaggerated poses v1.4.0 - Built-in mannequins (female / male) so the tool works before loading a VRM - Loading your own VRM replaces the mannequin - A second character gets the other mannequin automatically v1.3.0 - Bone locking: locked bones keep their angle when you swap the reference image and detect again, so you can combine several references - Lock by group, by box-select in the 3D view (Alt-drag to unlock), or one bone - Locked joints shown in orange v1.2.0 - Multi-view refinement: add extra views of the same pose to solve depth - Pick each extra view's angle; the main view still sets left/right and up/down - Bone-length limit keeps a poor extra view from making things worse