Unicode Text Policy Lab|文字比較・切り詰め診断12問・日英TXT+Python
- ダウンロード商品¥ 500
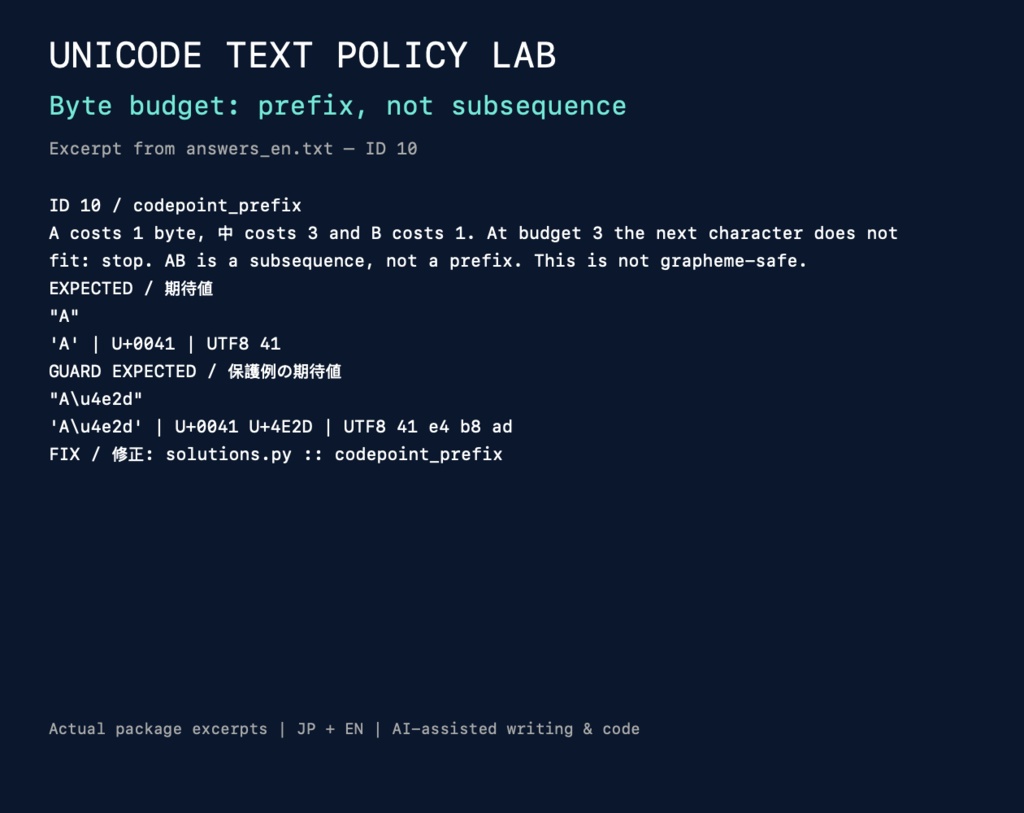
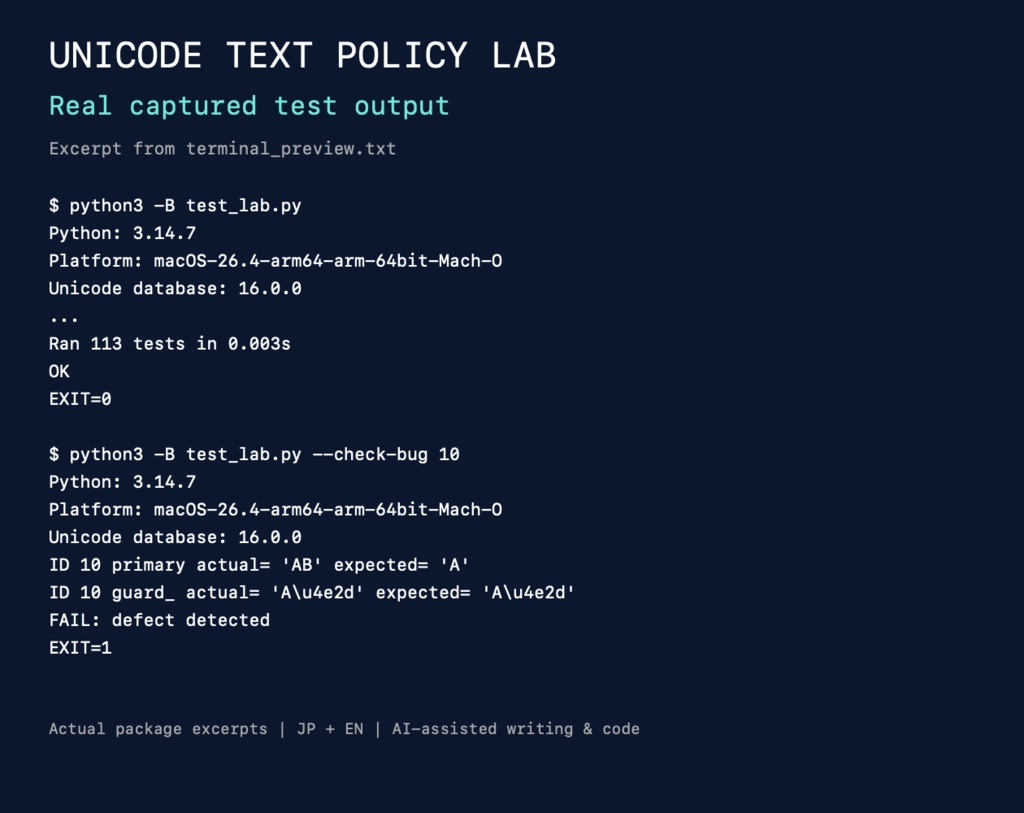


業務方針に沿って文字列を比較・整理・切り詰めるための、オリジナル12問の診断演習です。日本語・英語の問題と解答、故意の不具合コード、修正版、固定期待値、保護例を同梱します。 内容 NFC/NFD、元表記と出所を残す重複グループ、結合文字の順序、連結後の正規化、半角カナとNFKC、合字の保持、lowerとcasefold、点付きI、コードポイント・バイト・固定書記素サンプルの違い、連続接頭辞、明示的な不可視文字方針。 同梱:日英TXT、Python標準ライブラリのソース、113項目のテスト、手作業で定めた期待値、実際の端末ログ、参照元、利用許諾、ファイルmanifest。ZIP形式。TXTの閲覧だけならPython不要。実行には既存のPythonが必要で、追加依存のインストールは不要です。 検証範囲 Python 3.14.7/macOS 26.4 arm64/unicodedata 16.0.0でのみ検証。113項目成功、12個の故意の不具合を検出。Unicode全適合性試験ではありません。別のUnicodeデータベースでは未実行として終了します。casefoldは選択した写像のみUnicode 16と照合し、内部表の全検証はしていません。 書記素は明記した4つの固定サンプルだけに対応。汎用書記素分割器、任意の文字を安全に切るツール、同形字検出、実データの自動クリーナーではありません。他OS、実運用、授業での試用は未検証です。 利用許諾 購入者本人の学習・改変と、本人が直接教える授業で使用できます。その授業に必要な問題の抜粋と演習コードは受講者に限定して非公開配布できます。受講者は自習用に保持できますが再配布できません。ソース一式の配布、ソース一式・解答集の公開共有、教材の転売・改変版の再配布は禁止。組織全体のライセンスではなく、他講師による再利用は認めません。詳細はLICENSE.txtを参照してください。 AI開示 シナリオ設計、日英文、コード、テスト作成と見直しにAIを使用しました。プレビューは実際の教材と実行ログの抜粋で、架空のアプリ画面ではありません。 English: 12 complete Japanese-English policy-based Unicode debugging exercises. Personal learning and purchaser-taught classroom use permitted; necessary exercise excerpts may be shared privately within those classes. No public source/answer-pack sharing or resale. AI-assisted writing and code.