Hy-Nomasで迷宮探索する「ImageWorld」
- ダウンロード商品¥ 100
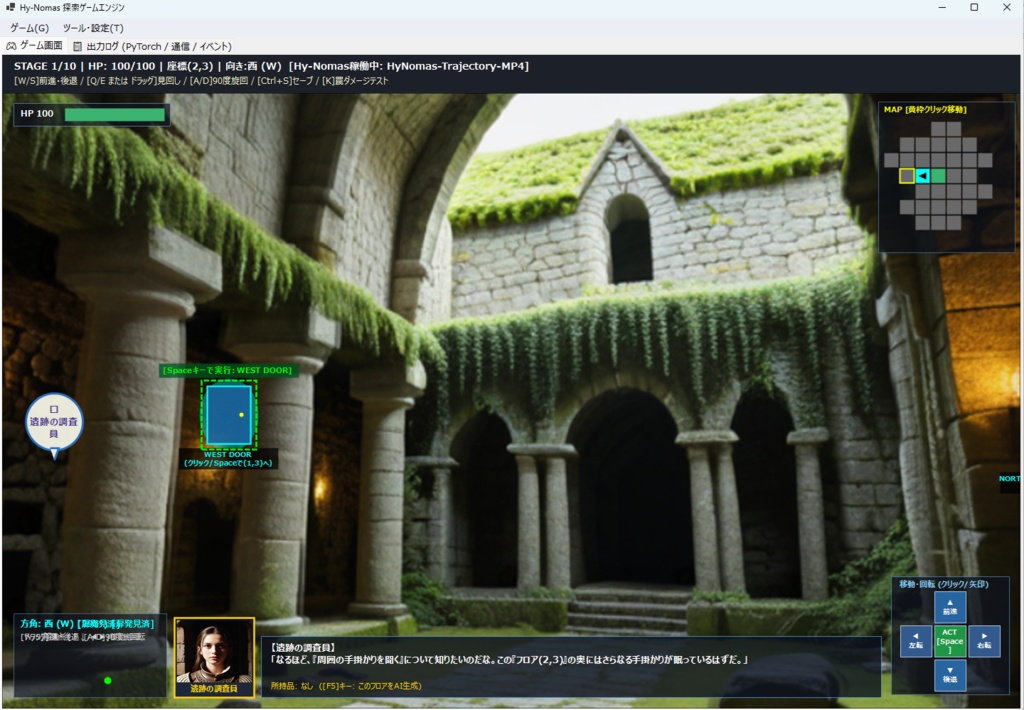
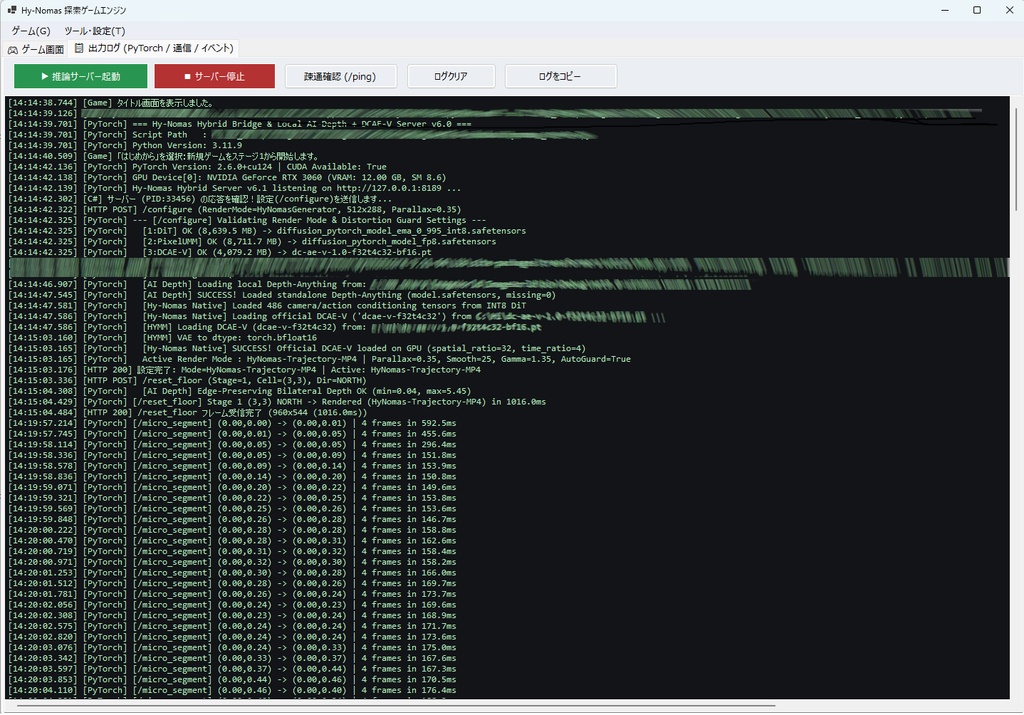
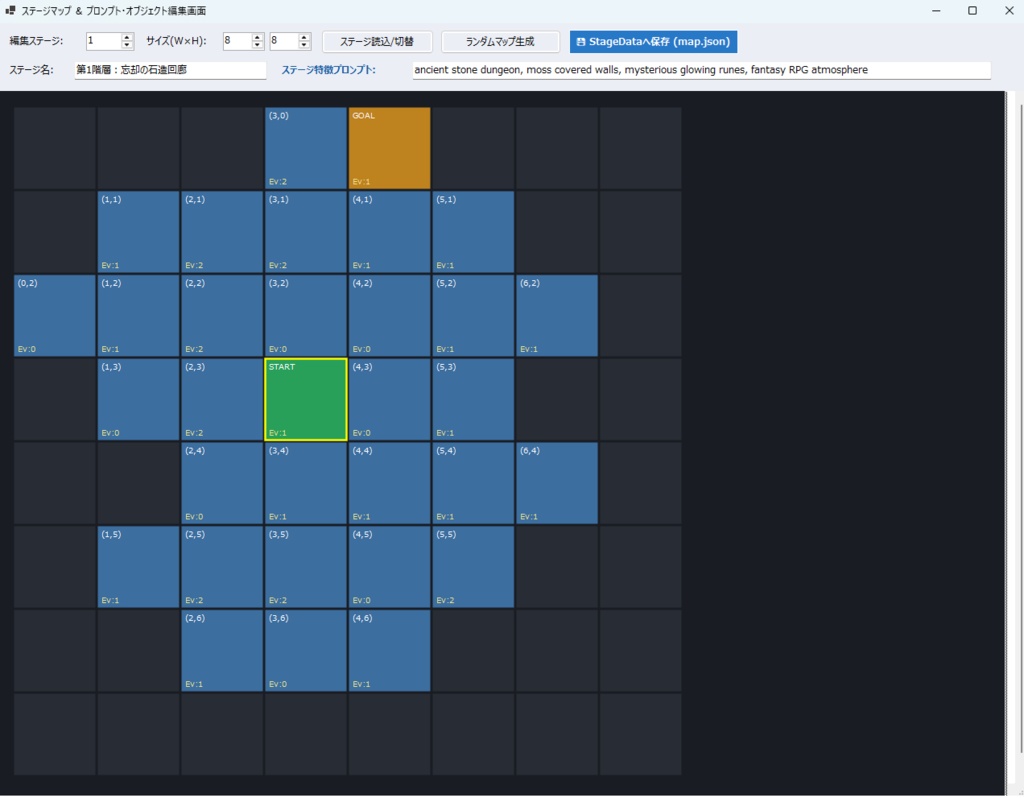
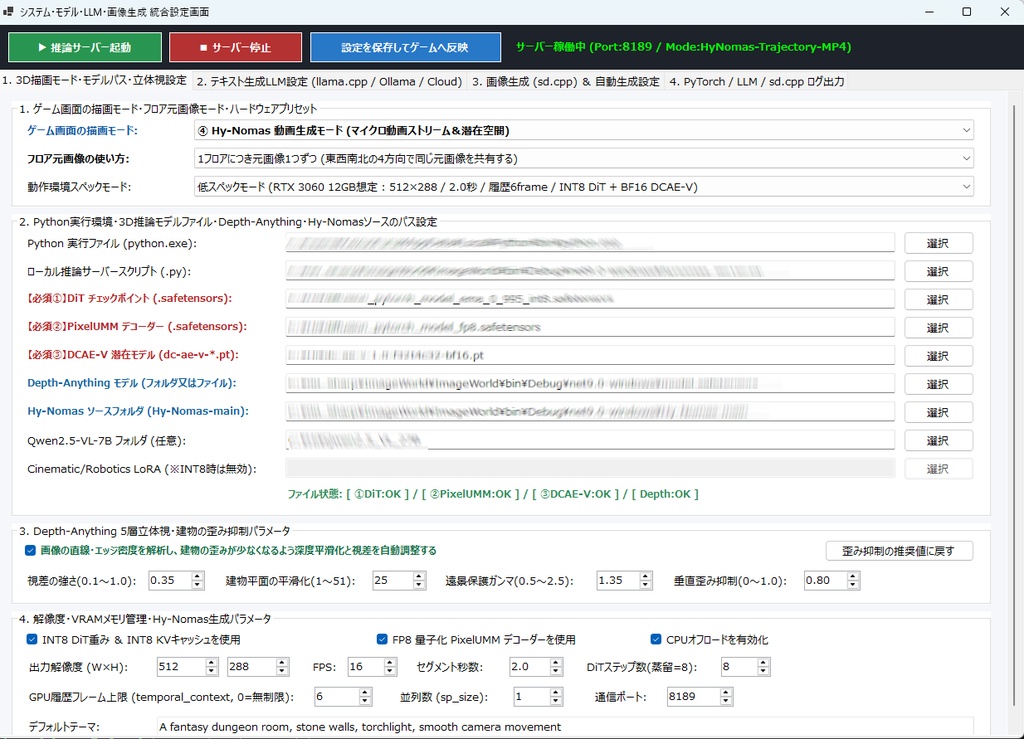
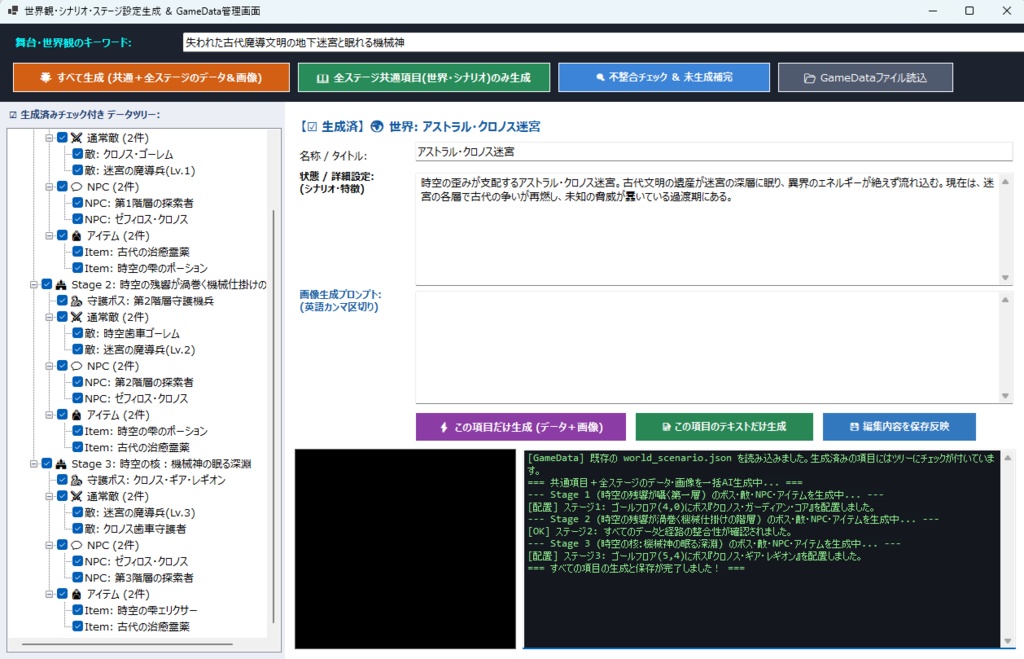


《疑似立体視の現状》 ・現状だと、各フロアの背景画像を ドラッグ&ドロップで視点移動させるなどして 擬似的な立体視を実現している程度です。 ・大ざっぱに言うと、 ニンテンドー3DSの立体視ぐらいの感じです。 ・つまり、絵の中を歩いて行ったりはできません。 ・しかし、うちのPCに搭載されたRTX3060(12GB)でも 普通に動作しますので、 そこは「Hy-Nomas」というモデルの すごいところかなと思います。 ・HyNomasのモデルファイルはこちら。↓ https://huggingface.co/tencent/Hy-Nomas ・「Qwen2.5VL」はこちら。↓ https://huggingface.co/Qwen/Qwen2.5-VL-7B-Instruct ・Githubにあるソースコードのダウンロードはこちら。↓ https://github.com/Tencent-Hunyuan/Hy-Nomas/archive/refs/heads/main.zip?utm_source=chatgpt.com ※本ツールの実行ファイルのあるフォルダ内に、 解凍したフォルダを配置して下さい。 ・「DepthAnything」(単眼深度推定AI)のモデルファイルはこちら。↓ https://huggingface.co/depth-anything/Depth-Anything-V2-Small-hf/tree/main ・これを使った方式だと、 ビデオメモリの少ないPCでも軽快に動作します。 ・ただしこれは、いわゆる深度マップなんで、 画質はちょっと荒くなります。 《機能説明》 (1) 概要 ・本システムは、 生成AI(テキスト・画像・深度推定)を統合し、 プレイヤーの行動や入力に合わせて 世界観、シナリオ、マップ、登場人物を 無限かつ動的に生成し続ける 新しい探索型RPGエンジンです。 (2) マトリョーシカ型 動的プロンプト生成 ・ローカルLLM(llama.cpp等)を利用し、 上位概念から下位概念へと 段階的に文脈(コンテキスト)を積み上げて データを生成します。 ・「世界観」→「シナリオ」→「階層(ステージ)」→ 「現在地(フロア)」→ 「NPC・敵・アイテム」→ 「次の行動選択肢」の順にAIが文脈を記憶・解釈するため、 自動生成でありながら 物語の破綻が極めて少ないのが特徴です。 (3) 5層マルチプレーン立体視エンジン Python側のサーバー ・(hynomas_server.py)と連携し、 Depth-Anything-V2モデルを用いて 画像を「最遠景・遠景・中景・近景・最近景」の 5つの奥行きレイヤーに分離します。 ・これにより、一枚の2D背景画像であっても、 建物の直線が歪むことなく、 「絵の中を歩いて進むような」リアルタイムの3D視差 (パララックス)を実現しています。 (4) 自由入力プロンプトによるNPC対話 ・NPCとの会話中、 プレイヤーが自由にテキストを入力して発言できます。 ・LLMが発言内容に応じて NPCの返答と「感情・状態の変化」を判定し、 状態が変化した場合は sd.cppがその場で新しい表情のポートレート(顔グラフィック)を 自動生成してゲーム画面に反映します。 (5) 部位狙い立体視バトルシステム ・敵モンスターと遭遇すると、 敵のイラストが拡大表示されます。 ・マウスドラッグで敵を立体的に見回しながら、 頭部や腕などの「部位」を狙って攻撃します。 ・視点を部位の方向に合わせることで 「立体視ロックオンボーナス(命中・威力アップ)」が 発生する アクション要素を備えています。