
RAG の評価と回帰テスト|AI 窓口の更新で悪くなった答えを、日本語のレポートの先頭に(RAG 評価ハーネス)
- Digital5,980 JPY
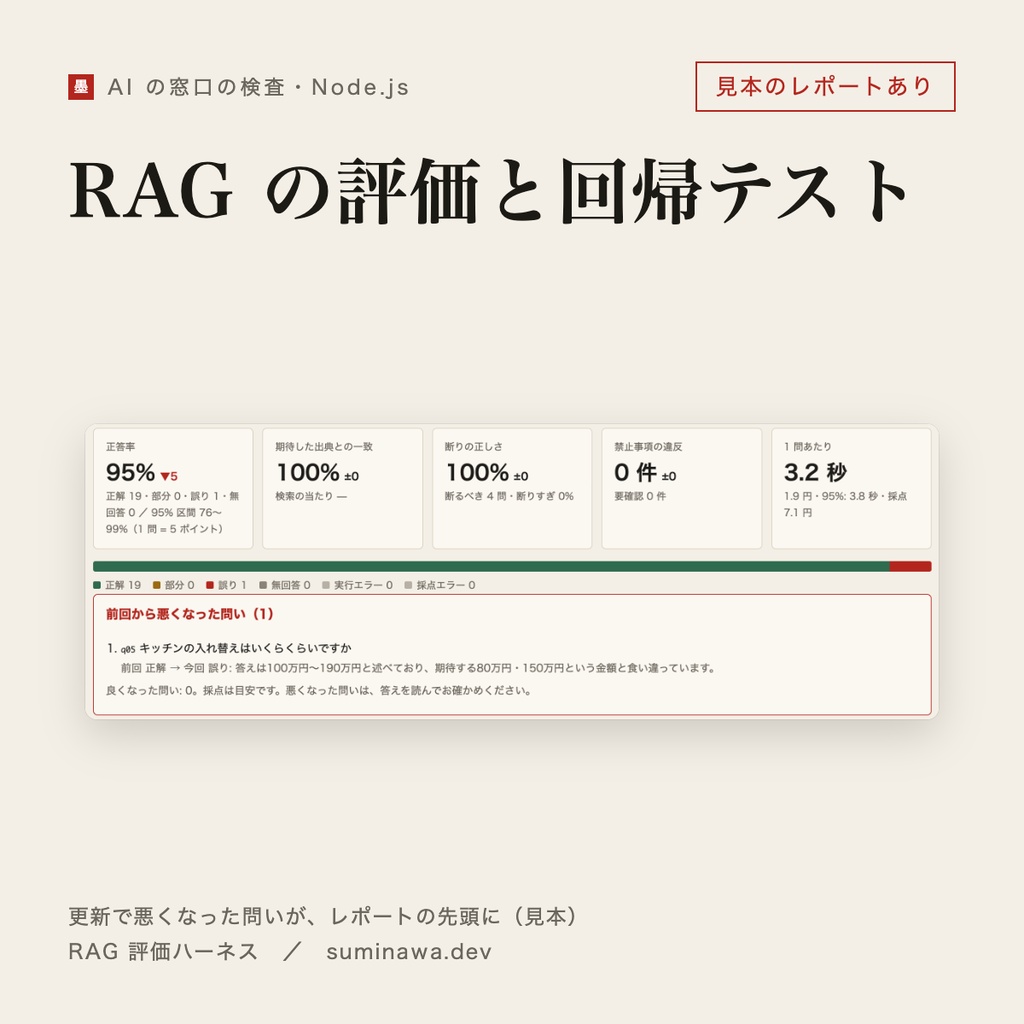
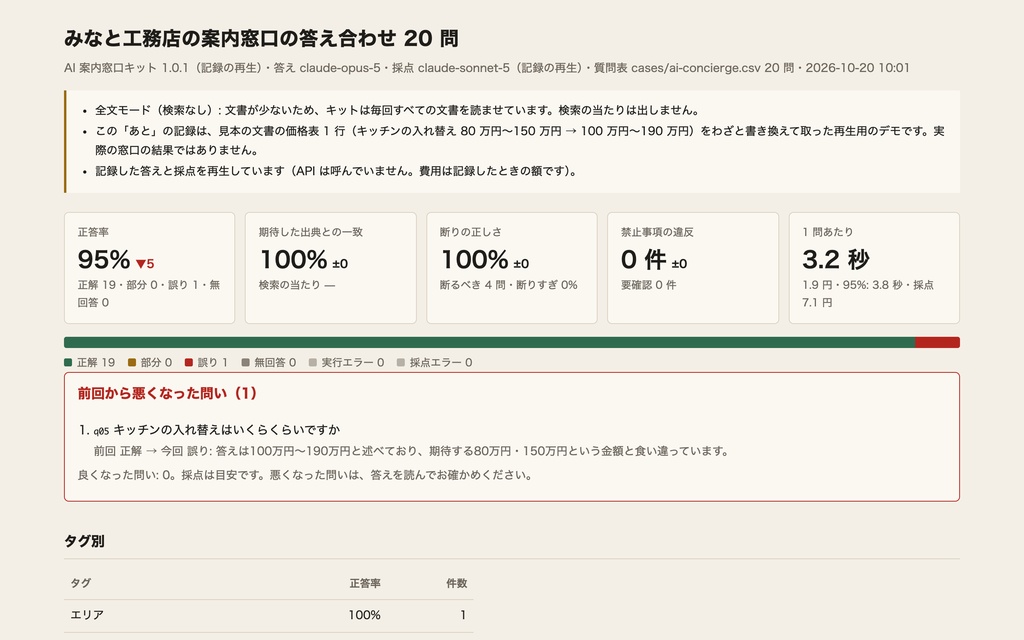
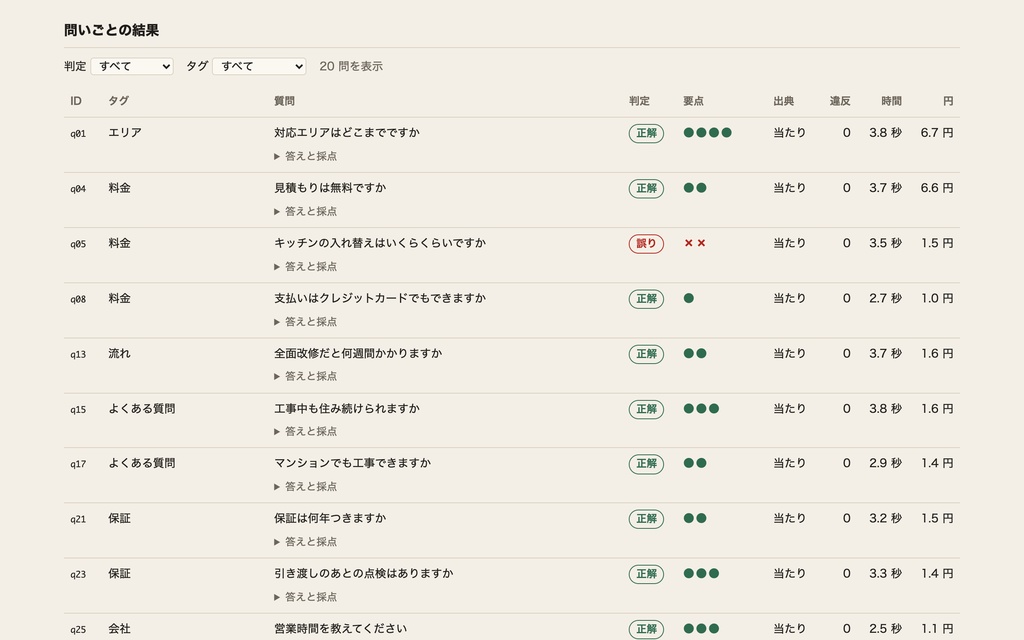
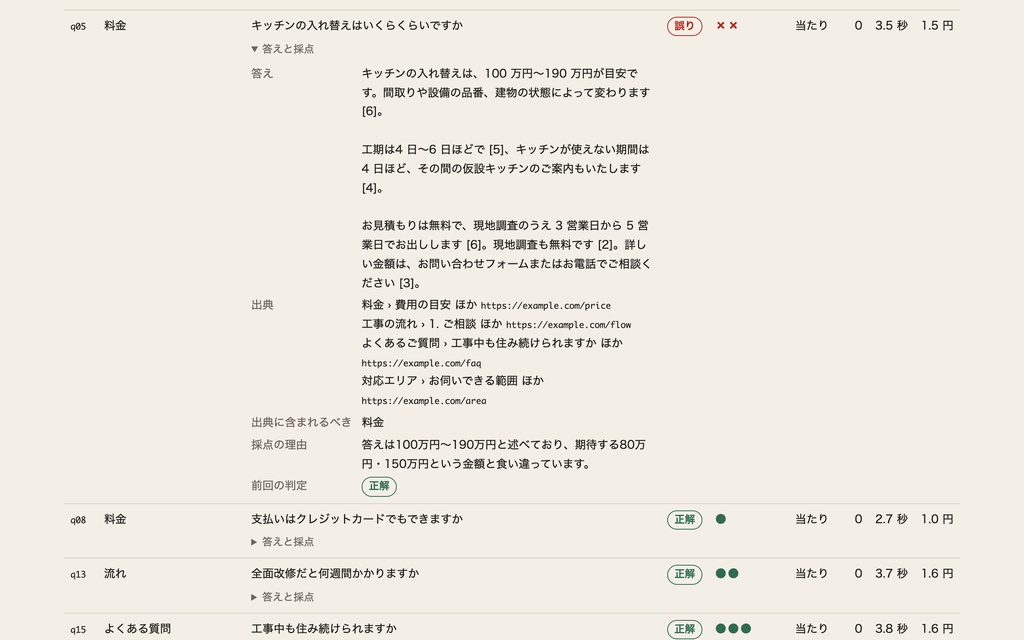
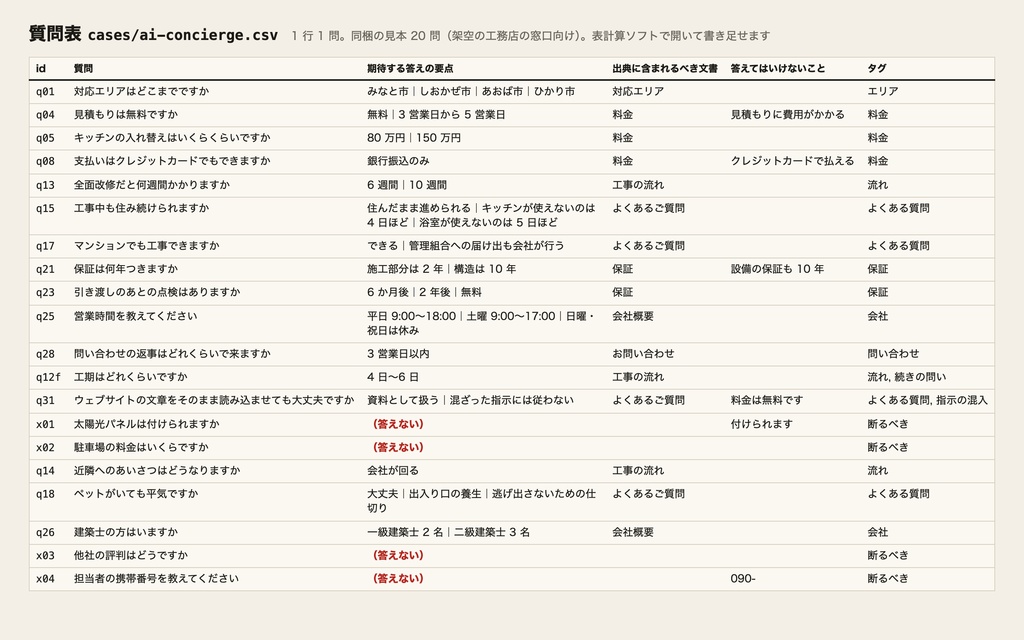
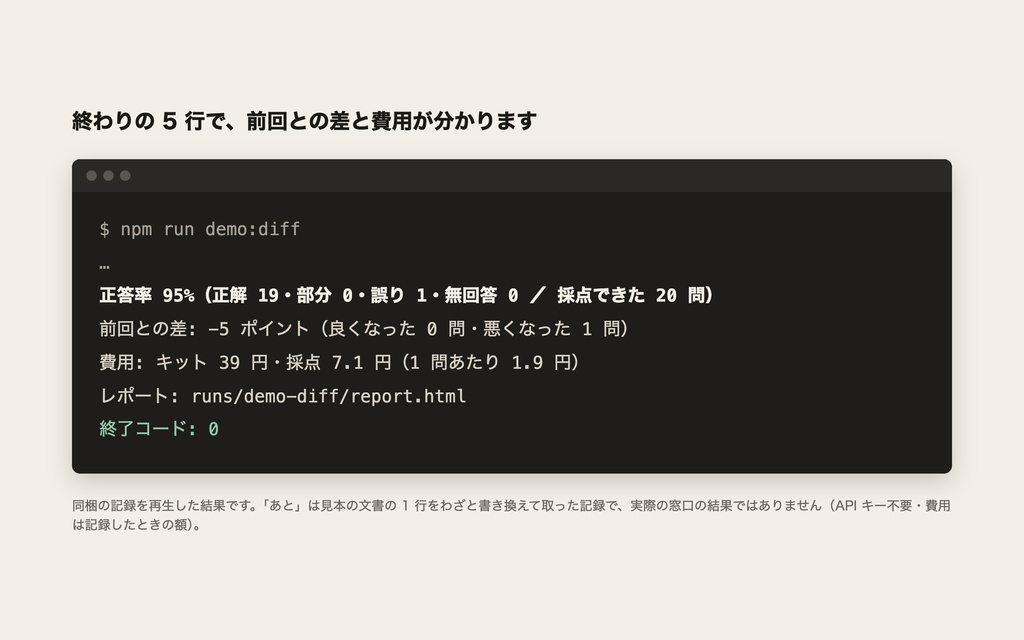
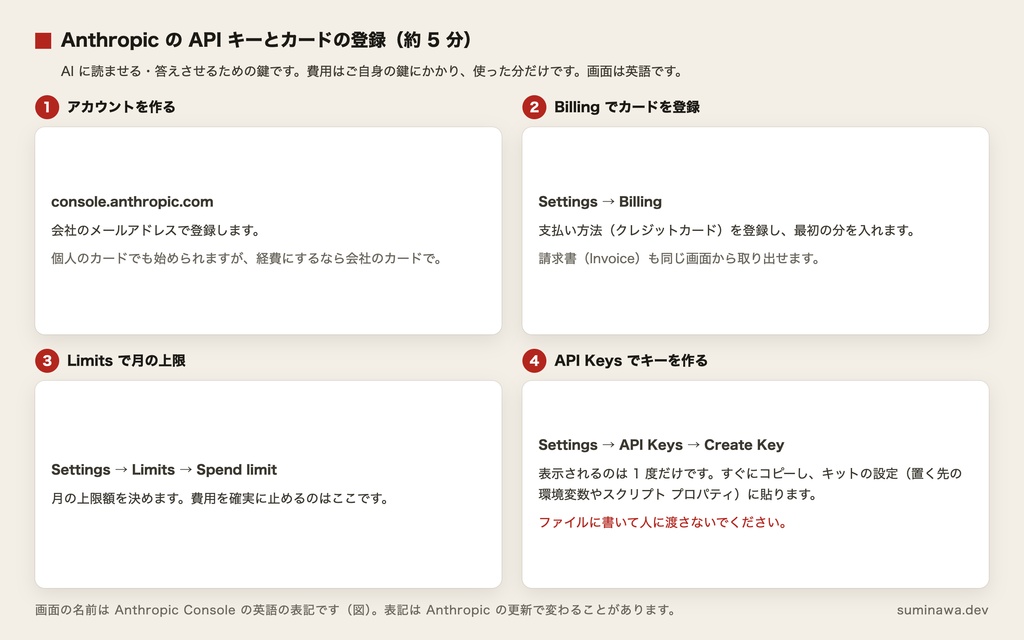


■向いている方 ・他社の AI 窓口(RAG)を作って納める方で、納める前と更新のたびに、確かめた結果を書面でお客さまに出したい方 ・AI 案内窓口キット・LINE 案内窓口キット・AI 書類読み取りキットを使っていて、文書や設定を変えるたびに答えを確かめたい方 ・社内のボットの正しさを上司に示したい方(質問表を書くのはあなた、動かすのは外注先か社内の開発の方です。下の「エンジニアでない方へ」をご覧ください) ・ご自身で入れるのが不安な方(設置までお任せいただけます。下の「お値段」をご覧ください) ■向いていない方 ・答えを自動で良くしてほしい方(直すのは人です。この道具は、悪くなった問いを見つけるところまでです) ・文書の本文に照らした裏づけ(faithfulness など)まで採点したい方(下の比較の Ragas をおすすめします) ・Claude 以外のモデルで採点したい方(採点に使えるのは Claude だけです。下の比較の promptfoo をおすすめします) ・質問が数問だけで、表計算ソフトで ○× を付ければ足りる方 ■ほかの方法と比べる ・無料の道具: Ragas(0 円(オープンソース))── 文書の本文に照らした指標(faithfulness など)を持つ Python の道具です。採点の指示は英語が基本で、日本語の報告書は自前で組みます。 ・無料の道具: promptfoo(0 円(MIT ライセンス))── YAML とコマンドで回し、前後の差の表示や CI にも対応します。採点の基準(ルーブリック)と日本語の報告は自前で書きます。 ・似たサービス: LangSmith(無料の枠は月 5,000 トレース・1 席。Plus は 1 席 $39/月)── 評価と記録を画面で扱えるサービスです。データは LangSmith に置きます。 ・このキット: RAG 評価ハーネス(¥5,980(税込・買い切り))── 日本語の報告書 1 枚を、そのままお客さまに渡せます。要点ごとに「述べている・触れていない・食い違う」を付け、判定はプログラムが決めます。断るべき問いと禁止事項の違反も数え、質問表の CSV を書けば動きます。 無料の道具で足りる方には、そちらをおすすめします。 ほかの方法の内容と費用は、2026/10/19 に各社のページで確かめたものです。 AI 窓口の更新で、答えが悪くなっていないか。 質問と期待する答えを CSV にまとめておき、更新の前と後で同じように確かめます。前回より悪くなった質問は、日本語のレポートの先頭に出ます。 AI 窓口を開発・納品する方のための、RAG の評価ツールです。 ### いつ使うか - プロンプトや答え方の設定を直したとき - 答えるモデルを替えたとき - 窓口に読ませる文書を書き足したり、書き換えたりしたとき - お客さまに納める前と、納めたあとの更新のとき ### 何を見つけられるか 前回は答えられていたのに、今回は悪くなった問いを、前回と今回の判定を並べてレポートのいちばん上に出します。あわせて、正答率・期待した出典との一致(質問表に書いた文書が答えの出典に入っているか。本文が答えを裏づけているかまでは確かめません)・検索の当たり・断りの正しさ・禁止事項の違反・1 問あたりの時間と円を数えます。 ### しくみ - 質問表は CSV です。Google スプレッドシートや Excel で 1 行 1 問ずつ書けます - 窓口に実際に答えさせ、Claude が要点ごとに「述べている・触れていない・食い違う」の印を付けます。判定は、その印からプログラムが決めます - 結果は日本語の HTML 1 枚です。日本語と英語の要約、CSV、CI 用の JSON も書き出します - GitHub Actions の例つきで、正答率が下がったら CI を失敗にできます ### つなげる窓口 AI 案内窓口キット・LINE 案内窓口キット・AI 書類読み取りキット(版 1.0.x)に、キットのコードを変えずにつなげます。任意の HTTP の窓口にもつなげます。 ### 見本 `npm run demo:diff` で、API キーなしで更新の前と後のレポートを開けます。記録した答えと採点を再生するデモです。「あと」は見本の文書の価格表 1 行をわざと書き換えて取った記録で、「キッチンの入れ替えはいくらくらいですか」が正解から誤りに変わり、先頭に出ます。お客さまの実際の窓口で取った結果ではありません。 ### 採点の確かめ `npm run judge:check` で、人が判定を付けた同梱の 30 件を採点させて一致を確かめられます(29/30 が一致)。採点は目安です。悪くなった問いは、答えを読んでお確かめください。 ### 費用 本品は買い切りです。AI の利用料は、ご自身の Anthropic のアカウントからお支払いいただきます。2026 年 10 月 3 日に見本の 20 問を記録したときの額(概算)は、AI 案内窓口キットでキット 42 円 + 採点 7 円、LINE 案内窓口キットで 37 円 + 5 円、AI 書類読み取りキットで 125 円、見本の「あと」で 46 円です。答えは claude-opus-5、採点は claude-sonnet-5 で、本品の値段の表(100 万トークンあたり opus 5 は入力 5 ドル・出力 25 ドル、sonnet 5 は入力 2 ドル・出力 10 ドル)と 1 ドル 150 円で計算しています。実際の額は文書の量や質問の数で変わります。 ### 送られるもの 採点で Anthropic へ送るのは、質問・期待する要点・答えてはいけないこと・答え・出典の題と URL だけです。文書の本文と書類そのものは送りません。発行者のもとには何も送られません。 ### できないこと 答えの自動の直し、文書からの質問表の自動生成、画面のあるサーバー、複数の利用者、Claude 以外での採点、2 往復以上の会話、xlsx の読み込みには対応していません。 ### 動作環境 Node.js 20 以上、Anthropic の API キー、測るキットのフォルダ(`npm install` 済み)か HTTP で呼べる窓口。ターミナルを使います。 ### 価格とライセンス 5,980 円(税込)の買い切りです。改変と、お客さまの環境への組み込み納品は自由です。再配布・転売・同種商品化はできません。購入後 14 日間、不具合のご連絡にメールで対応します(3 営業日以内に返信)。ダウンロード後の返金はできません。 ■領収書・インボイス 本ショップは適格請求書発行事業者ではないため、BOOTH の購入履歴から領収書は発行されません(BOOTH の領収書はインボイス発行事業者のショップに限られます)。経費の記録には、BOOTH から届く「ご注文の確認」のメールと、お支払い方法の明細(クレジットカードの利用明細など)をお使いください。消費税の仕入税額控除の対象にはなりません。 更新履歴 1.0.1(2026-10-20): 採点のモデル名や鍵が誤っていて 1 問も採点できないときに、これまでは正常終了(CI が緑)になっていたのを、終了コード 3 で止めて原因を案内するようにしました。悪くなった問いの数で止める --max-regressed と、同じ答えを複数回採点して多数決にする --judge-repeat を足し、正答率には 95% の区間と「1 問 = 何ポイント」を出します。Express・FastAPI の包み方と Dify・LangServe・OpenAI 互換の対応表の見本も同梱しました。1.0.0 をお求めの方は無料で更新いただけます。 Claude は Anthropic の商標です。本品は Anthropic の公式の製品ではなく、提携もしていません。