SBV3 ― Style-Bert-VITS2 の学習を新しくした、AivisSpeech 向け音声モデル学習ツール(無料)
- Digital0 JPY
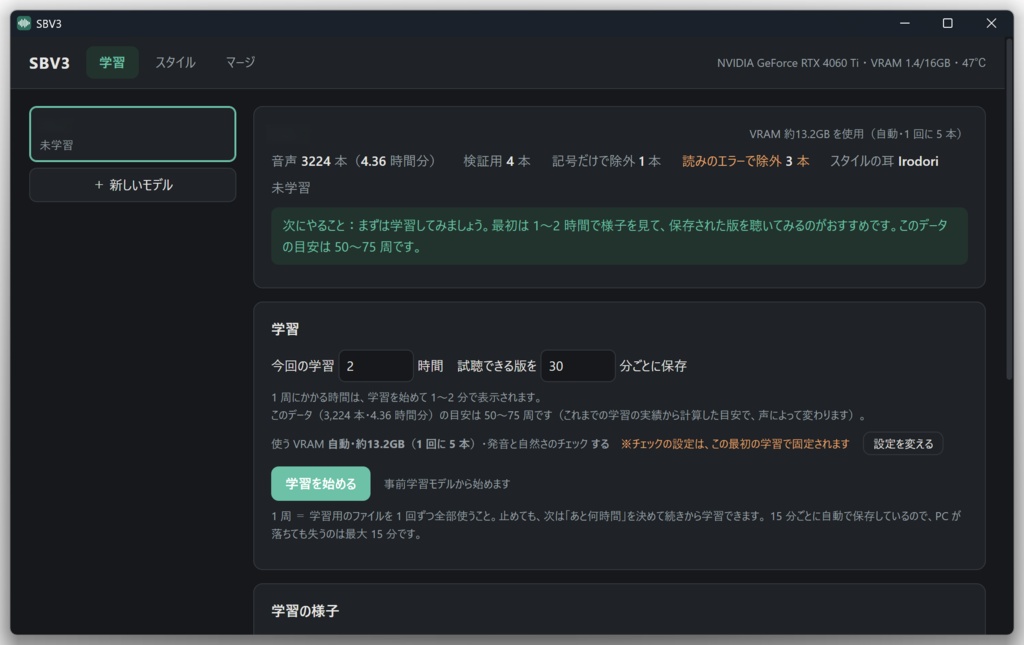
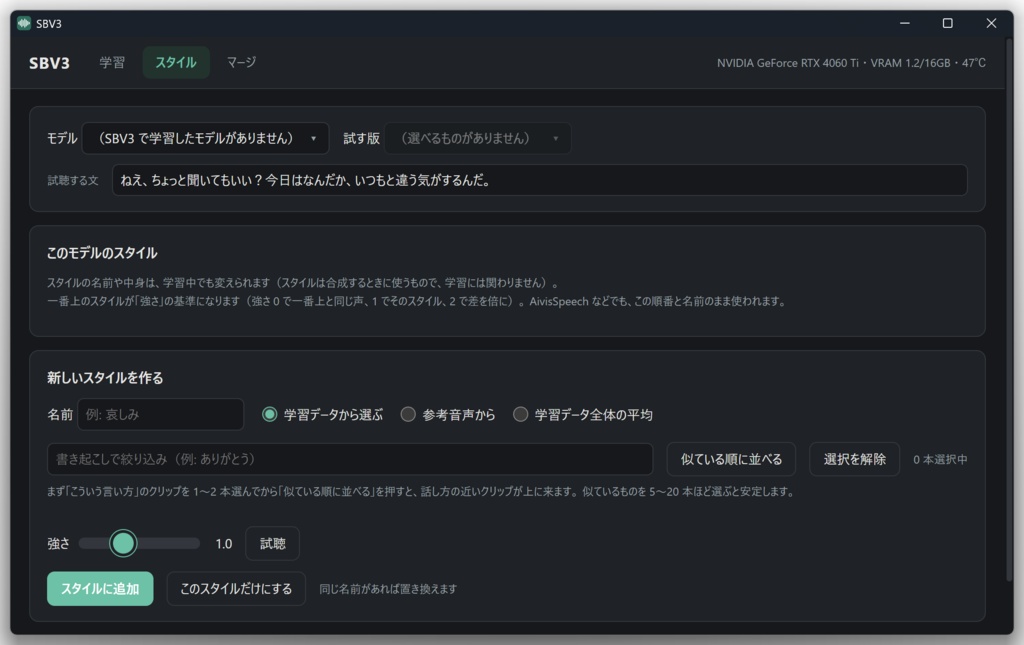
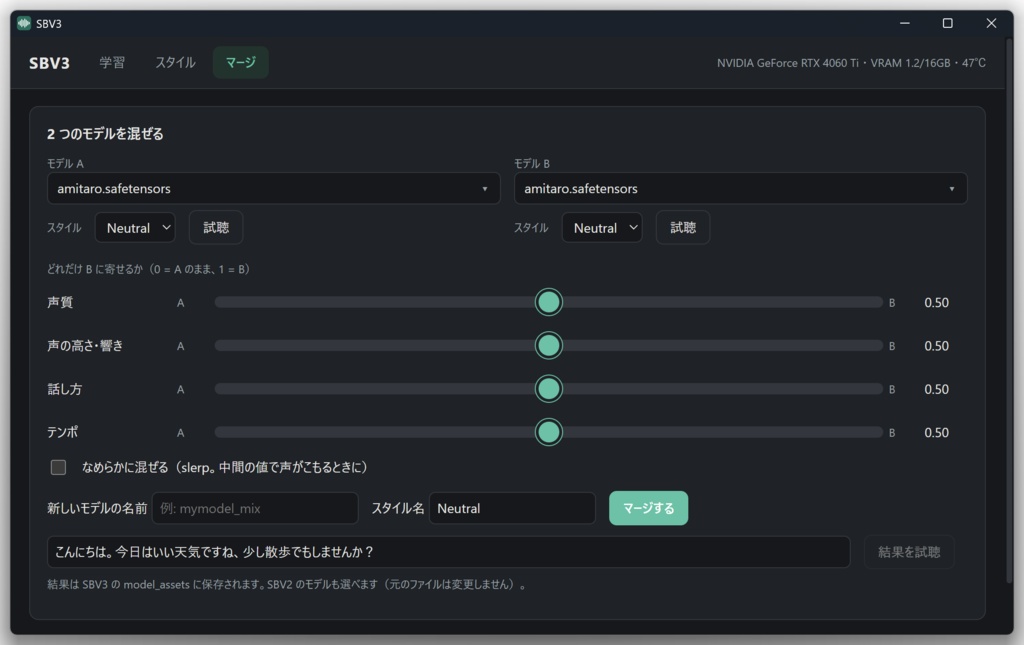


【概要】 Style-Bert-VITS2(JP-Extra)の学習部分を見直して作り直した、Windows 用の学習アプリです。 できるモデルは Style-Bert-VITS2 JP-Extra と同じ形なので、AIVIS 公式の AIVM Generator で変換すればAivisSpeech でそのまま使えます。 学習・スタイル作り・マージだけに絞った、はじめての方にも分かりやすい画面にしました。 NVIDIA の GPU が無い方は、同梱の Google Colab 版で学習できます。 【特長】 ■ 速く、正しく学習する ・RTX 4060 Ti 16GB での実測で、1 秒あたりに学習できる音声の本数が Style-Bert-VITS2 の約 2.3 倍 (Style-Bert-VITS2 は 1 回 2 本、SBV3 は 1 回 4 本で比べたときの数字です) ・Style-Bert-VITS2 で働いていなかった「発音・自然さのチェック」(WavLM)が、正しく効くようにしました ・毎回同じ順番で学習していた点、長い音声が学習から外れていた点などを直しました ■ 止めても消えない ・「止めて保存」ボタンで、いつでも止められます。15 分ごとの自動保存もあり、PC が落ちても続きから学習できます ・「今回は 2 時間だけ」のように時間を決めて学習できます。続きから学習するのに、設定ファイルを書き換える必要はありません ・データの本数と長さから、「何周くらい学習すればよいか」の目安を画面に出します ■ VRAM が足りなくても遅くならない ・VRAM からあふれて普通のメモリを使い、学習がとても遅くなる現象を起こさないようにしています ・使う VRAM の量は自動で決まります(GB で指定することもできます)。8GB から 96GB の GPU まで対応しています ■ 名前を付けて、欲しいスタイルを 1 つずつ作れる ・勝手にたくさんのスタイルを作るのではなく、「このスタイルが欲しい」というものを名前を付けて作ります ・学習データから似た音声を選んだり、手持ちの参考音声から作ったりできます ・話し方や感情を聞き取る「耳」に、Irodori-TTS の参照エンコーダ(日本語向け)を使っています ■ マージ ・2 つのモデルを混ぜて、新しいモデルを作れます 別々のデータで学習したモデル同士でも混ぜられます(スタイルの「耳」が同じモデル同士に限ります) ■ 採点 ・保存した版を、学習データに無い 12 文で読ませて聞き取り、読み間違いの割合を出します(anime-whisper を使用) どの版が良いかを選ぶ参考になります 【動作環境】 ・Windows 10 / 11(64 ビット) ・NVIDIA の GPU(VRAM 8GB 以上、おすすめ 12GB 以上) GTX 10 シリーズ以降(RTX 20・30・40・50 シリーズ、RTX PRO 6000 Blackwell など) ・NVIDIA のドライバ 570 番台以降(CUDA Toolkit を入れる必要はありません) ・ディスクの空き 25GB 以上 ・初回のセットアップのときだけインターネット接続(約 8.5GB をダウンロードします) ・展開する場所のフォルダ名に、日本語などの全角文字が入っていないこと(例: C:\SBV3 は OK、C:\音声\SBV3 は NG) GPU が無い場合:Google アカウントがあれば、Google Colab 版で学習できます。 Colab 版でできるのは学習・試聴・採点です。スタイル作りとマージは Colab 上ではできませんが、 Colab で作ったモデルをパソコン版の SBV3 に置けば、スタイル作りもマージ(パソコンで作ったモデルとの組み合わせも可)もできます。 【同梱物】 ・SBV3.exe(起動用)とプログラム一式(ソースコードを含みます) ・使い方.txt ・Colabで使う方法.txt と SBV3_colab.ipynb(Google Colab 版) ・LICENSE(AGPL-3.0)・CREDITS.md(使っているモデルとプログラムの一覧) 【はじめかた】 1. zip を展開し、SBV3.exe をダブルクリックします 2. 初回だけ、必要なものを自動でダウンロードします(10〜40 分ほど) 3. 画面の「使い方の流れ」に沿って、データのフォルダを選んで学習を始めます 学習に使うデータは、wav ファイルと esd.list(書き起こし)が入ったフォルダです。 【ご注意】 ・学習に使ってよいのは、権利を持っている声、または本人の許可がある声だけです ・作ったモデルや音声の使い道は、学習に使った声の権利と、各サービスの規約に従ってください ・Google Colab 版は Colab の利用規約に従ってご利用ください(ディープフェイクの作成は禁止されています) ・初回の起動で「Windows によって PC が保護されました」と出た場合は、「詳細情報」→「実行」で起動できます ・すべての環境での動作を保証するものではありません 【ライセンス】 SBV3 は Style-Bert-VITS2(AGPL-3.0)を改造したもので、SBV3 も AGPL-3.0 です。 ソースコードはすべて同梱しています。AGPL-3.0 の条件のもとで、改造や再配布ができます。 使っているモデル・プログラムとそのライセンスは、同梱の CREDITS.md に書いてあります。 【クレジット】 ・Style-Bert-VITS2(litagin02 / AGPL-3.0) ・Style-Bert-VITS2 JP-Extra 事前学習モデル(litagin / AGPL-3.0) ・Irodori-TTS v4-Small 参照エンコーダ(Aratako / MIT) ・Semantic-DACVAE-Japanese(Aratako / MIT) ・deberta-v2-large-japanese-char-wwm(ku-nlp / CC BY-SA 4.0) ・WavLM Base Plus(Microsoft / MIT) ・anime-whisper(litagin / MIT) 【免責】 本ソフトの利用により生じたいかなる損害についても、作者は責任を負いません。 【お問い合わせ】 【販売者名】まで BOOTH のメッセージでご連絡ください。 【更新履歴】 v0.1.0 初版