
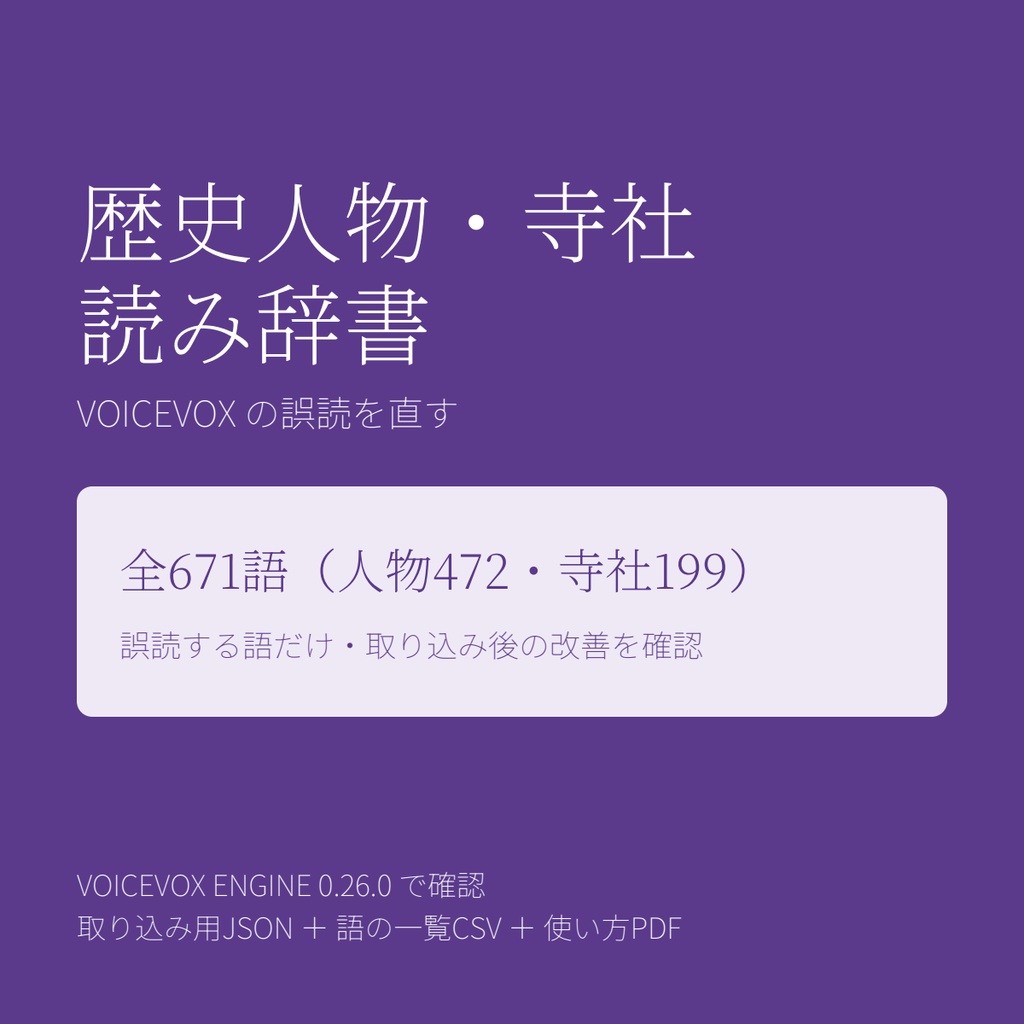
VOICEVOX 読み辞書 歴史人物・寺社671語|誤読する語だけ・商用可・取り込み用JSON+CSV+PDF
- ダウンロード商品¥ 500


VOICEVOXで歴史解説や朗読を作るとき、人名や寺社名が誤読されることがあります。その読みを、まとめて直すための辞書です。1語ずつ登録する手間が減ります。
内容
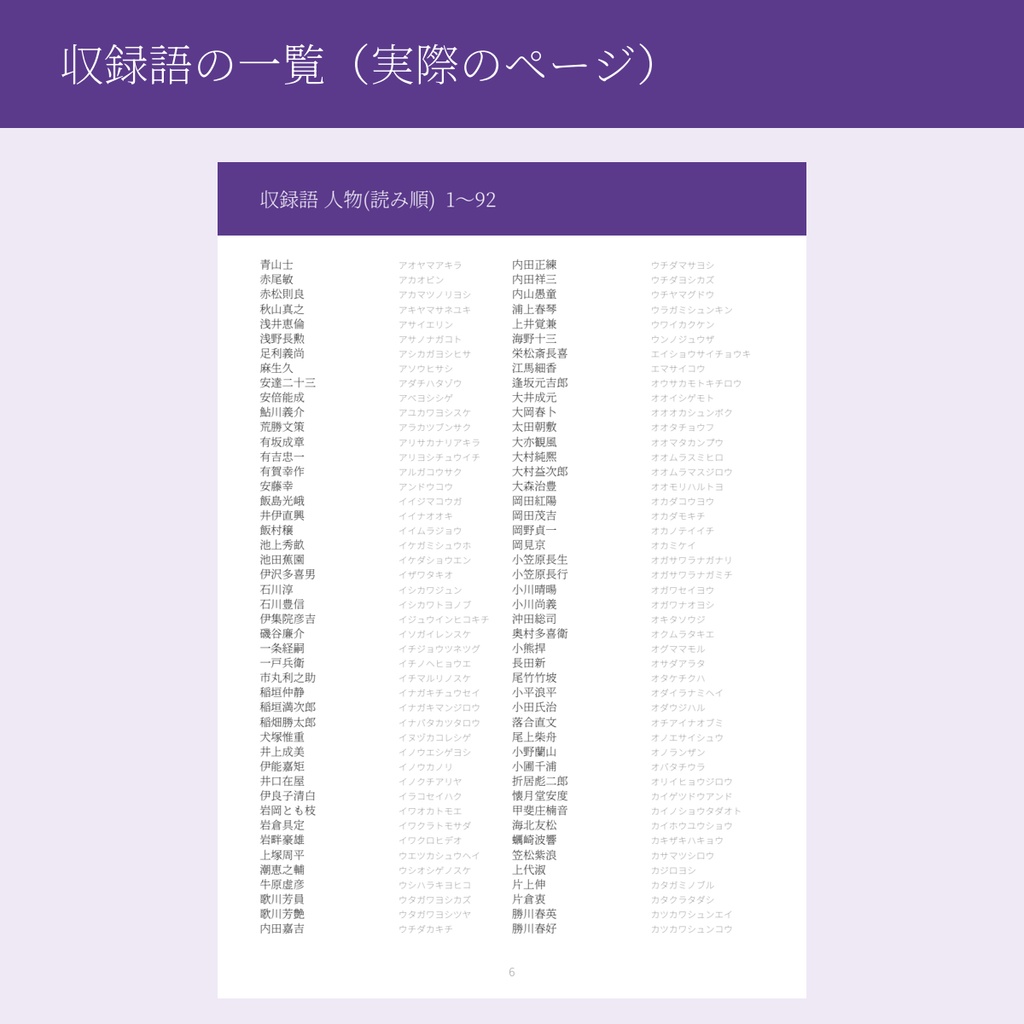
・取り込み用の辞書ファイル(voicevox_user_dict.json) ・語の一覧(words.csv。表記・読み・種別) ・使い方PDF(取り込みの手順、注意、収録語の一覧つき) ・収録: 歴史上の人物472語、寺社199語、あわせて671語
収録語の例(表記 → 読み)
・青山士 → アオヤマアキラ 中井猛之進 → ナカイタケノシン 福士政一 → フクシマサイチ ・北野天満神社 → キタノテンマンジンジャ 大念仏寺 → ダイネンブツジ 南洲神社 → ナンシュウジンジャ ・全671語の一覧は、PDFとCSVにあります。購入前に確かめたい場合は、BOOTHのメッセージでお問い合わせください(一覧の公開はしていません)。
特徴
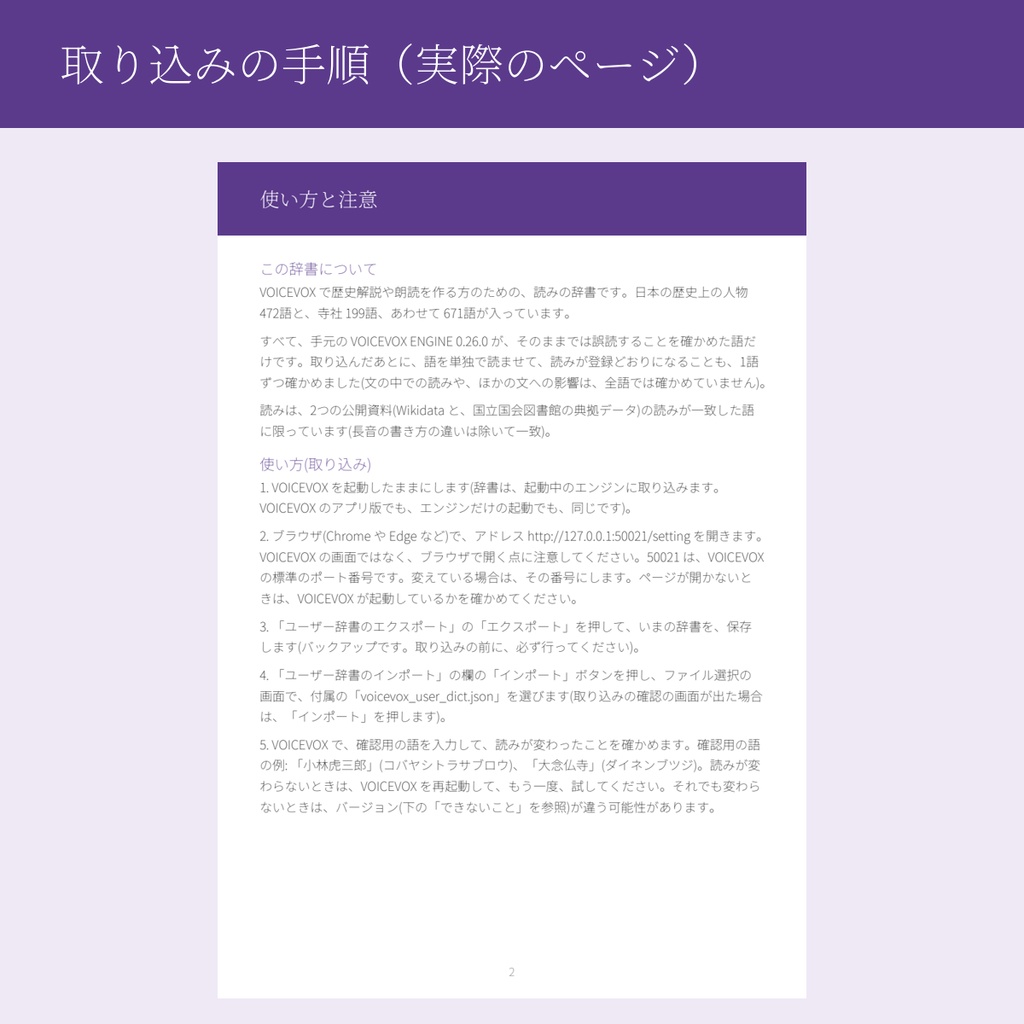
・VOICEVOX ENGINE 0.26.0 で、そのままでは誤読する語だけを収録しています。 ・取り込んだあとに、語を単独で読ませて、読みが登録どおりになることを、全語で確かめました(長音の書き方の違いは同じとして比べています。文の中での読みや、ほかの文への影響は、全語では確かめていません)。 ・読みは、2つの公開資料(Wikidata と、国立国会図書館の典拠データ)が一致した語に限っています(長音の書き方の違いは除いて一致)。 ・同じ表記で読みが分かれる語、全国に同名が多い寺社名は、除いています。 ・取り込みは、VOICEVOXの起動中に、ブラウザで http://127.0.0.1:50021/setting を開き、「ユーザー辞書のインポート」から行います(アプリ内の設定画面ではありません)。 ・取り込むと、あなたがすでに登録した語に、この辞書の語が足されます。登録済みの語は消えません。
収録している語の範囲
◇ 人物: 1300年から1899年に生まれた日本の人物(現存者を含みません) ◇ 寺社: 日本の寺院と神社 ・1300年より前に生まれた人物(古代から鎌倉時代前期。藤原道長、紫式部など)は収録していません。この時代の名前は「藤原の道長」のように「の」を入れて読む慣習があり、資料にその「の」が書かれないため、読みを確定できないからです。
ご注意(購入前にお読みください)
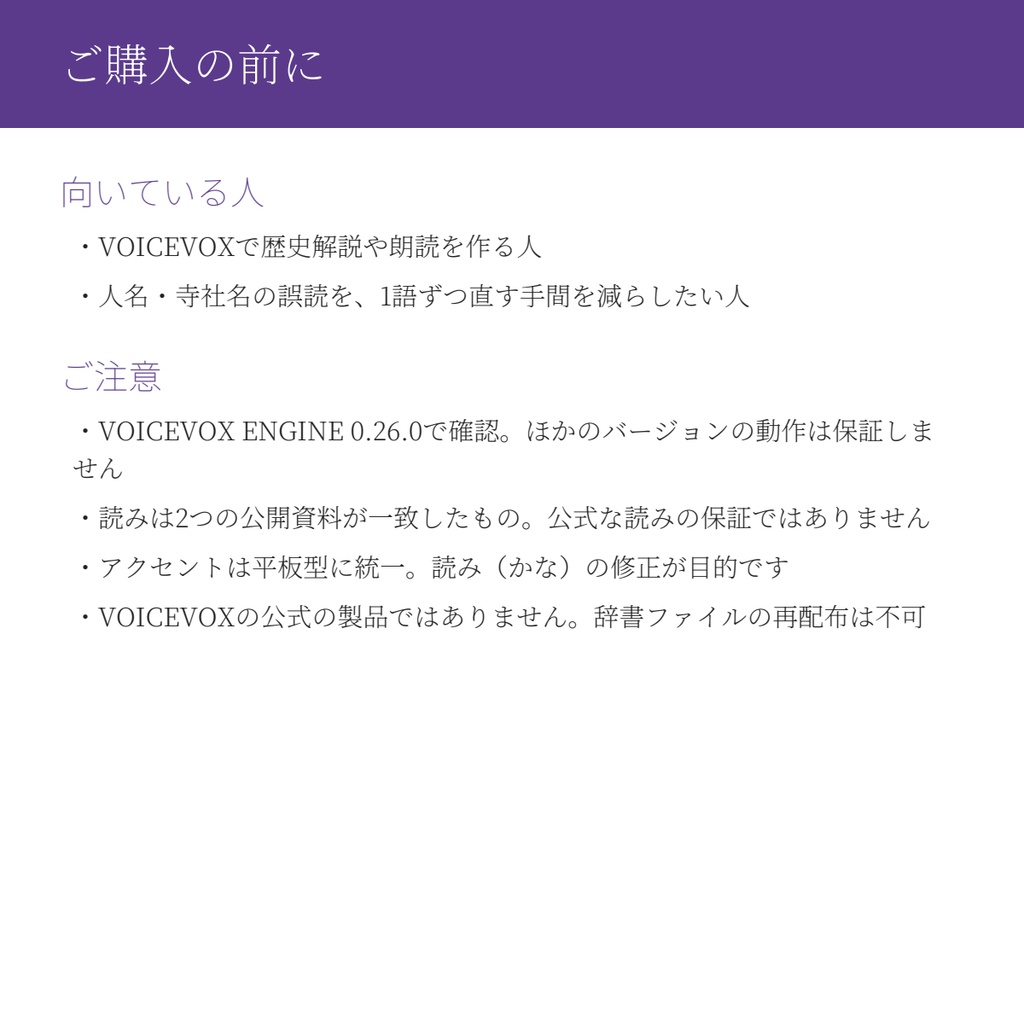
・VOICEVOX ENGINE 0.26.0 で確認しました。ほかのバージョンでの動作は保証しません。 ・アクセント(抑揚)は、すべて平板型(抑揚を付けず、平らに読む型)で登録しています。違和感のある語は、VOICEVOXの辞書の画面で、アクセントを直せます。読み(かな)の誤りを直すための辞書で、アクセントの自然さは保証しません。 ・読みは、2つの公開資料が一致したものです。公式な読みや、唯一の正解であることを保証するものではありません。 ・VOICEVOXの公式の製品ではありません。VOICEVOX本体と各キャラクターの利用規約は、別に定められています。購入者が、それぞれに従ってください。 ・取り込む前に、いまの辞書のエクスポート(バックアップ)を取ってください。手順はPDFにあります。 ・プログラムと文面は、生成AIで下書きを作り、販売者が見直しました。専門家の校閲は受けていません。 ・この商品は更新しません。誤りに気づかれたときは、BOOTHのメッセージでお知らせください。内容は確認しますが、修正版の提供はお約束していません。
利用条件
・この辞書を使って作った動画や音声作品は、商用を含めて公開してかまいません。 ・辞書ファイル(JSON、CSV)とPDFの、転載・再配布・再販売はできません。
速度の目安
・読み上げの下準備(VOICEVOXの読み取得)の平均は、辞書の取り込み前が約3ミリ秒、取り込み後が約9ミリ秒でした(作者の環境で、300語を測定)。エンジンの起動は、辞書が空のとき約1.8秒、683語を取り込んだとき約2.8秒でした(1回ずつの測定。収録語数が少し違う時点の値です)。
参照した資料(2026年11月14日に参照)
・Wikidata(構造化データはCC0) ・Web NDL Authorities から取得(国立国会図書館が作る、人名や団体名の標準的な形と読みのデータ)