
【無料】ADVゲーム等の実況音声作りに!動画内の字幕を話者付きで書き出せるOCRツール「RecoOCR - レコシア -」
- 無料ダウンロードダウンロード商品¥ 0
- 【支援プラン】なんかおいしいもの(中身は同じです)ダウンロード商品¥ 500
- 【支援プラン】けっこうおいしいもの(中身は同じです)ダウンロード商品¥ 1,000
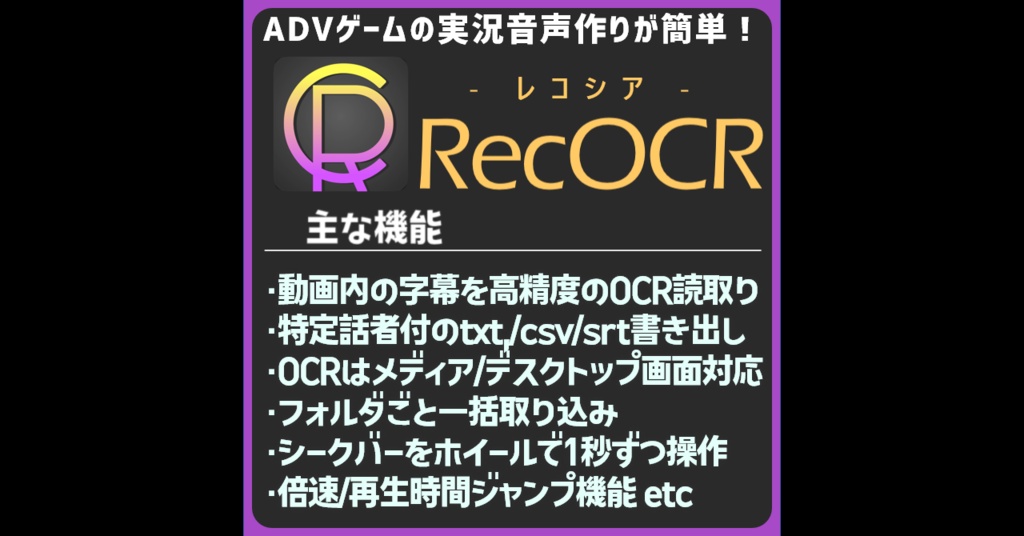

ゲームや動画の台詞を画面から読み取り、「誰が話したか」付きで書き起こす Windows 用のOCRツールです。 読み取った台詞は、合成音声ソフトにそのまま取り込める CSV / TXT 形式や、SRT 字幕として書き出せます。 〈こんな悩みに!〉 ・ゲームの台詞を合成音声で読ませたいけど、手で打ち込むのが大変 ・画面の文字をOCRにかけても、誰の台詞なのかを後から振り分け直すことになる ・SnippingToolのOCRは使っていてもテキストが多くコピペが大変
■ 特徴
・1〜9キーで話者を選ぶと、その瞬間の台詞を読み取って話者付きで1行追加 ・入力ソースは2種類 ・デスクトップ:ホットキー(既定 Ctrl+Alt+O)で画面の範囲を選んで読み取り ・画像・動画:ファイルをドラッグ&ドロップで開き、再生しながら読み取る範囲を指定 ・動画の読み取りは2つのモード ・通常モード:一時停止して1〜9キー、その場で1行ずつ確認・編集 ・連続モード:再生を止めずに1〜9キーを押していくモード。読み取ったテキストはスタックされるので読み込み待ちを減らせます ・動画から取り込んだ行には再生位置を記録。時刻をクリックするとその場面へ戻れます 〈その他の機能〉 ・OCRエンジンは2種類から選択 ・RapidOCR(PP-OCR):既定。ドット・低解像度・圧縮で崩れたゲーム字幕に強い ・Windows OCR:Windows標準の文字認識。鮮明な画像で高精度 ・読み取り前の画像補正(拡大・グレースケール・コントラスト強調・ノイズ除去・二値化・色反転)を選んで適用可能 ・日本語の誤字補正(AI/ネット接続不要)。辞書と「見た目の似た文字」、文のつながりから「永速→永遠」「芳働→労働」のような誤りを直します ・オフ/候補を提示(元の文は変えない)/自動修正 の3段階から選べます ・辞書にある正しい語は変更しません ・多数決OCR:条件を変えて何度か読み取り、文字ごとに多数決で結果をまとめます(精度優先・低速) ・話者プリセット:話者名を「話者名,プリセット名」と登録すると、声の種類を3列目に書き出せます ・書き起こしは自動保存。アプリが落ちても次回起動時に復元されます ・プロジェクトとして名前を付けて保存し、作品ごとに切り替えられます ・動画は 0.25〜8倍速の再生、音量・ミュート、ホイールでのシーク、同じフォルダの前後のファイルへの移動に対応 ・OCRは別プロセスで動くため、読み取り中も画面が固まりません ニコニコでの投稿の場合、親作品登録は任意ですが登録していただければ喜びます。
■ 使い方
1. 入力ソースを選ぶ ・左パネルの「入力ソース」で、デスクトップ/メディアを選びます 2. 話者を登録する ・「設定」タブで、1〜9キーそれぞれに話者名を登録します 3. 読み取る ・デスクトップ:「画面切り取り」または Ctrl+Alt+O で、読み取りたい範囲をドラッグします ・メディア:画像・動画を開き(ドラッグ&ドロップ可)、映像の上をドラッグして読み取り範囲を指定します ・話者に対応する 1〜9キーを押すと、その台詞が話者付きでリストに追加されます 4. 整える ・リストの話者はプルダウンで変更、台詞はダブルクリックで編集できます ・誤字補正を「候補を提示」にしている場合は、該当行が強調され、候補ボタンで採用できます 5. 書き出す ・合成音声ソフト用には「CSV」または「TXT」、字幕には「SRT」で保存します
■ 話者プリセットについて
・「設定」タブの話者名を「話者名,プリセット名」のように半角カンマで区切ると、カンマ以降をプリセット名として3列目に書き出します ・一部の合成音声ソフトは、この3列目を「その話者の声の種類(プリセット)」として読み込みます ・プリセットを1つも使っていない場合、3列目は付きません ・一部の行だけプリセットを指定した場合、指定の無い行の3列目は空欄になります
■ インストール
・ダウンロードした zip を任意の場所に展開します ・展開された RecoOCR フォルダ内の RecoOCR.exe を起動します ・フォルダ内のファイルは移動・削除せず、フォルダごと扱ってください ・初回起動時に「WindowsによってPCが保護されました」と表示された場合は、「詳細情報」→「実行」を選んでください(署名の無いアプリで表示されるものです) アンインストールは RecoOCR フォルダを削除するだけです。 (設定を保存できない場所に置いた場合は %LOCALAPPDATA%\RecoOCR に保存されるため、そちらも削除してください)
■ 注意事項
・台詞やプリセット名に半角カンマ(,)が含まれると、取り込み側で列がずれます。書き出し時に該当する行の件数をお知らせしますので、全角の読点(、)に置き換えてください ・OCRの性質上、読み取り結果が完全に正しいとは限りません。書き出し前にリストで内容をご確認ください ・設定と書き起こしは RecoOCR.exe と同じフォルダに保存されます。そこへ書き込めない場合(Program Files 配下など)は %LOCALAPPDATA%\RecoOCR に自動で保存します ・読み取る画面・映像の著作権は各権利者に帰属します。書き起こした内容の利用は、各作品の規約の範囲内でお願いします ・本ソフトウェアは無保証です。利用により生じた損害について作者は責任を負いません
■ 動作環境
・Windows 10 / 11(64bit) ・既定の RapidOCR は追加の設定なしで動作します ・Windows OCR に切り替える場合のみ、Windowsの日本語言語パックが必要です (設定 → 時刻と言語 → 言語と地域 → 日本語 → オプション → 「基本入力」をインストール) ・展開後のサイズは約480MBです
■ ライセンス
・MIT License ・改変・再配布可。詳細は同梱の LICENSE をご確認ください
■ クレジット
・以下のソフトウェア・データを利用しています ・RapidOCR / PaddleOCR(PP-OCR モデル):OCRエンジン(Apache License 2.0) ・ONNX Runtime:推論エンジン(MIT License) ・OpenCV:画像処理(Apache License 2.0) ・PySide6(Qt for Python):画面表示(LGPLv3) ・pynput:ホットキー(LGPLv3) ・PyWinRT:Windows OCR の呼び出し(MIT License) ・RapidFuzz:誤字補正の候補検索(MIT License) ・wordfreq:語彙の頻度辞書(MIT License) ・Pillow / NumPy:画像処理・数値計算(MIT-CMU / BSD License) ・Tatoeba(https://tatoeba.org/)日本語文コーパス:誤字補正用の文脈モデルの作成元(CC BY 2.0 FR) 同梱しているのは文から抽出した単語の出現頻度のみで、文そのものは含みません ・SudachiPy / SudachiDict:文脈モデル作成時の単語分割(Apache License 2.0)
アップデート履歴
・v1.1.0 初回リリース